OpenAI在同一套GPT-6编号下摆出了两副截然不同的账本。
一边是顶配旗舰Astra。官方宣称它把调研耗时与成本双双砍半,底层的标准费率却暴涨了两倍半;另一边是同日跟进的Sol与Luna,标称API单价全线腰斩50%,顺手下线了原本最便宜的Terra。
天下熙熙,皆为利来。这场看似两端发力的产品调整,既不是无私的技术普惠,也不是单纯的旗舰溢价。底层智力的突破一旦撞上边际递减的硬墙,算力的账本就会变得格外精细。
名义腰斩与单价暴涨:一套精编的价目表
价目表上的数字往往只负责制造第一印象。
Astra的标准输入每百万token收取10美元,输出高达50美元。对比上一代主力GPT-5.6 Sol的4美元输入与20美元输出,基础费率直接跳涨了2.5倍。更苛刻的规则压在长上下文两端:单次请求输入只要迈过27.2万token门槛,费率立刻翻倍,输出单价同步涨到1.5倍。
为了稳住被高价吓退的中间层客户,OpenAI同日给出了降价方案。新版GPT-6 Sol将输入输出压到2美元与10美元,轻量版Luna压到0.10美元与0.50美元,名义降幅整整50%。配套的提示词缓存读取折扣给到一折,但新增了此前被忽略的门槛:缓存写入费用分别定在每百万token 2.50美元与0.125美元。
纸面降价很快在实际运行中变了味。第三方机构Artificial Analysis在实测中发现,在最高推理档位下,Sol单任务成本为1.06美元,Luna为0.07美元。两者实际任务支出的差距收窄到15倍,远低于名义Token标价标榜的20倍。
| 模型版本 | 输入单价 (1M tokens) | 输出单价 (1M tokens) | 缓存写入费用 (1M tokens) | 核心定位与计费特征 |
|---|---|---|---|---|
| GPT-6 Astra | $10.00 | $50.00 | 动态阶梯 | 超27.2万Token单价翻倍,主打高阶统筹 |
| GPT-6 Sol | $2.00 | $10.00 | $2.50 | 较前代腰斩50%,实测任务成本收窄 |
| GPT-6 Luna | $0.10 | $0.50 | $0.125 | 取代Terra,极端低价但易丢关键要素 |
| Claude Opus 5.5 | $4.00 | $20.00 | 动态阶梯 | 同日直降40%,卡位中高端工程交付 |
长思考Token的快速膨胀,加上反复校验与缓存写入开销,迅速抹平了账面单价的降幅。高阶模型用复杂规则收割溢价,平价模型用机制损耗回血,算盘打得极其周密。
跑分口径拆借与内部互踩
官方材料拿出的FrontierMath Tier 4高达98%、ARC-AGI-3达99.9%,榜单看似无懈可击。但只要把工程基准单独拎出来,优势就缩成了一条细缝。
Gemini 3.8 Flash的输入单价只要0.75美元,相当于Astra的十三分之一,DeepSWE跑分却能咬到几乎平手。
宣传视频里的船厂、戴森球和复杂园林,本质上是模型写出CAD脚本去调用外部渲染引擎。BenchCAD衡量的是尺寸数字对不对,真正的展UV、贴图烘焙和骨骼绑定,模型全都没做。4.2%的低幻觉率出自闭卷断网的冷门题库,到了实际项目里,它依然会在未经确认时擅自改动数据库表结构。
Sol与Luna的评测同样充满口径腾挪。在OSWorld 2.0离线测试里,Sol在xhigh档位拿到60.5%,官方借此宣称以五分之一的成本打平了Claude Opus 5中等档位的60.3%。但技术社区随后发现,官方采用的是宽松的部分奖励机制,对手此前采用的是严苛的严格奖励规则,两者口径根本无法互认。
更尴尬的是产品线自相践踏。Artificial Analysis独立测算显示,GPT-6 Sol在最高档位下的智能指数仅从前代的47微涨到48,Luna停留在37。在软件工程基准DeepSWE 1.1中,旧款GPT-5.6 Sol最好成绩是72.7%,GPT-6 Sol最高档反而跌落到68.8%。更令架构师费解的是,Luna在最高档位跑出66.6%(单任务0.22美元),恰好持平Sol在xhigh档位的66.6%(单任务1.00美元)。同样的得分,成本差了78%。
并发黑洞与隐性交付代价
网络智能体公司Parallel给出的耗时减半案例,成了官方宣传的核心抓手。但深入拆解流程就会发现,这并非单次推理有了速度突破,而是把任务打散给多个子智能体并发执行。
挂钟时间确实被压短了,代价是上下文载入计费在暗中成倍翻滚。
在Parallel自家的公开搜索榜上,Astra平均耗时34.7秒,每千次任务成本为301美元;上一代Sol耗时52.9秒,成本只有217美元。处理成本反而高出39%。如果调用架构没有严密配置缓存,每个子分支都要完整塞入一份庞大上下文,并发越多,消耗累加越快。
廉价模型带来的则是交付质量的缩水。低价的Luna在长文本生成中频繁丢失关键字段与格式;Sol为了降低幻觉率,收缩了回答体量并增加拒答,导致长文本知识评测准确率从59%跌至54%。开发者为了修补漏项,不得不追加前置约束、发起自动化重试甚至人工审核,纸面省下的费用全被下游工程运维吞噬。
鵜鶘的穿帮与防御战
演示视频里刻意致敬Simon Willison的骑车鹈鹕,本意是宣告模型彻底解决了空间布局难题。真实测试的反馈要现实得多。
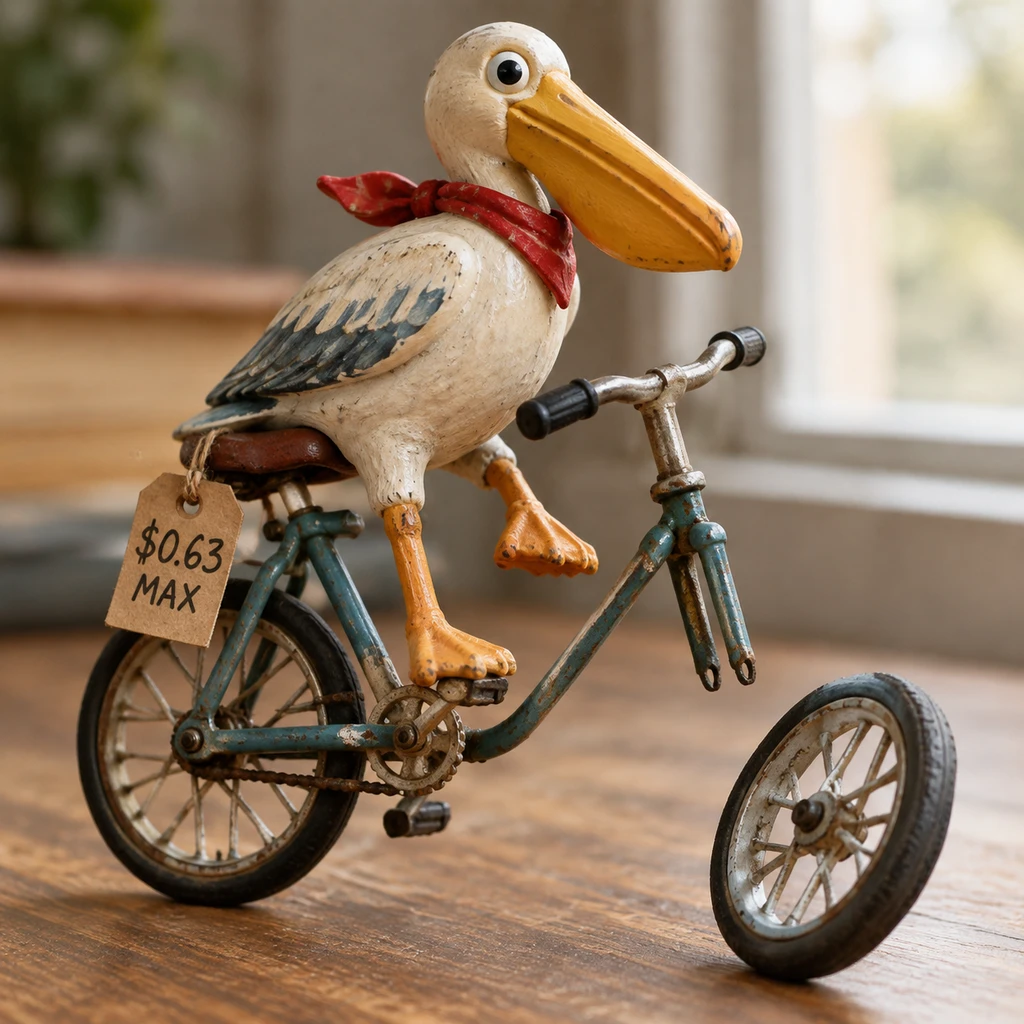
在最低推理档位下,花掉约9.55美分,Astra画出的鹈鹕确实好过Sol的所有档位。但如果把推理强度推到63美分的顶峰,只要档位稍有回退,鸟腿与脚踏板、车架之间的脱节穿模依然频繁出现。
更微妙的是推理收益的倒挂。在多项基准测试中,Astra拉到最高推理档,得分反而低于次高档。过度思考没能解开逻辑死结,反而在枝节上反复消耗Token。
这让人想起早年跨洋海底电报按字计费的旧景:线路越昂贵,冗余信息对发报者的惩罚就越直接。竞争对手没有留出从容调整的窗口。Anthropic在同日推出Claude Opus 5.5,不仅修正了长文本风格,还将调用价格压到输入4美元、输出20美元,直奔中高端自动化流水线而来。
高低两端的拉锯挑明了当下的行业处境:单靠堆参数换取智力跃迁的周期正在降速,厂商开始精打细算地打防御战。对工程团队而言,盲目跟进所谓腰斩模型只会踩入重试泥潭;唯一的对策是极其严密的动态路由,把极少数高难规划留给顶层,其余常规任务死守廉价通道。