教科书里白纸黑字写了四十年的结论,在一柄凿子和高倍显微镜下被当场掀翻。
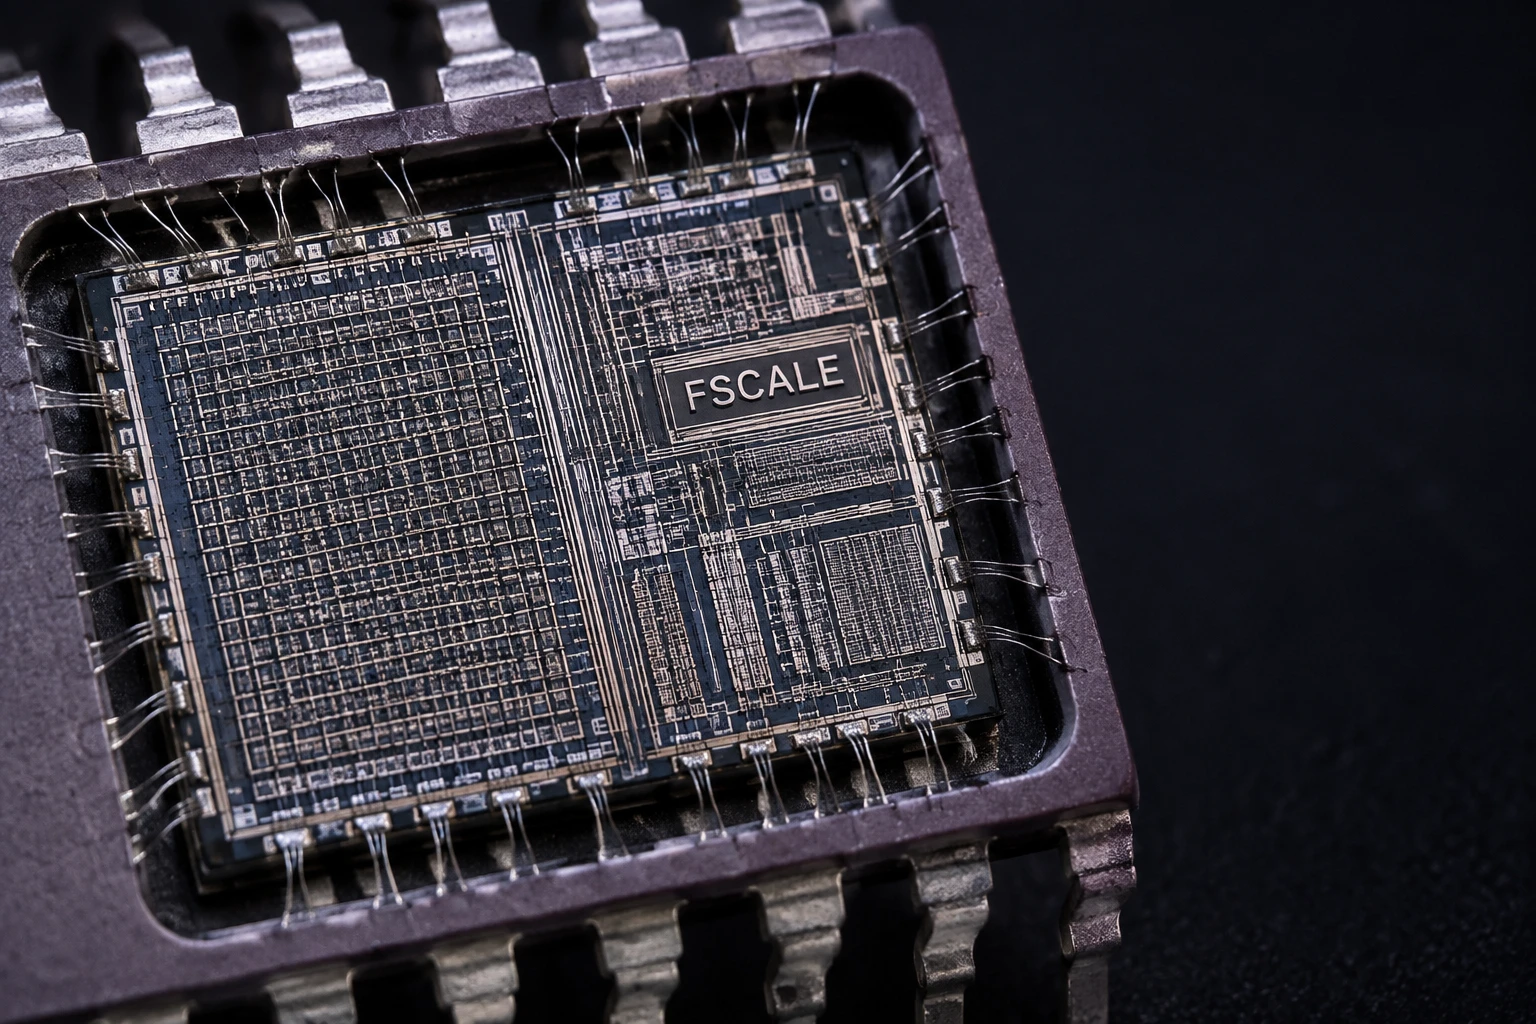
硬件逆向工程师 Ken Shirriff 剥开一枚 1980 年出厂的 Intel 8087 浮点协处理器陶瓷外壳,反编译片内 1,648 条原始微码后发现,计算机界长期奉为定论的三角函数实现全被猜错了:它的核心正切指令 FPTAN 根本不是纯粹的 CORDIC 算法,而是一套从未见诸公开文献的混合数学架构。
在此之前,人们刚刚从这枚芯片里逆向出另一套奇观:为了执行一条看似基础的浮点缩放指令 FSCALE,8087 竟然靠微码偷偷篡改栈顶指针寻址,并跨通路硬借乘除法移位器来截断指数。
当把这两项实锤拼在一起,一个被神话掩盖了四十余年的底层真相浮出水面:被奉为现代浮点计算基石的 8087,骨子里从来不是什么优雅的数学殿堂,而是一座在 4 万晶体管牢笼里靠借道、省料、甩包袱甚至欺骗硬件拼凑出来的工程奇迹。
教科书讲了四十年,显微镜下一击即碎
先看这次显微逆向推翻的核心事实。
自 1956 年 Jack Volder 提出 CORDIC 算法以来,这种只靠移位和加减法就能解算三角函数的机制,就统治了早期的导航计算机与掌上计算器。数十年来,体系结构专著都理所当然地写道:Intel 8087 的超越函数微码就是标准 CORDIC 的硬件化身。
显微镜下的真实微架构把这套理论击得粉碎。8087 内部负责超越函数的常量 ROM 只有可怜的 42 个数值,其中用于正切旋转的步进角常数仅仅存了 16 个,从 $\arctan(1)$ 覆盖到 $\arctan(1/16384)$。
这意味着芯片只转了 16 步就停手了。
标准 CORDIC 算法每迭代一步只收敛 1 位精度。若要填满 80 位扩展双精度所需的 64 位尾数,纯 CORDIC 必须循环整整 64 步,并匹配巨大的常数阵列。当时 8087 采用 3–4.5 µm 工艺,物理面积只有 5mm×6mm,晶体管总预算咬死在 4 万到 4.5 万只之间,根本撑不起这种硬件开销。
Intel 架构师的解法是把理论撕开:CORDIC 转到第 16 步强行截断,留下一个小于 $2^{-16}$ 的残差角 $r$;随后微码迅速切入一道低阶 Padé 有理逼近式:
$$\tan(r) \approx \frac{3r}{3 - r^2}$$
在数学上,这个公式在泰勒展开后同时抵消了一阶与三阶误差项。残差小于 $2^{-16}$,经过有理式放大后五阶截断误差被压到了 $2^{-64}$ 之下,恰好卡进 64 位有效精度的及格线。
在没有任何专用硬件乘法矩阵的前提下,8087 靠这套杂交拼盘把正切运算干到了 90 微秒,比起 8086 纯软件模拟的 13,000 微秒,性能直接拉升 144 倍。
偷指针、借移位器与甩包袱的 API
这种对物理极限的极限压榨,贯穿了 8087 的每一个角落。
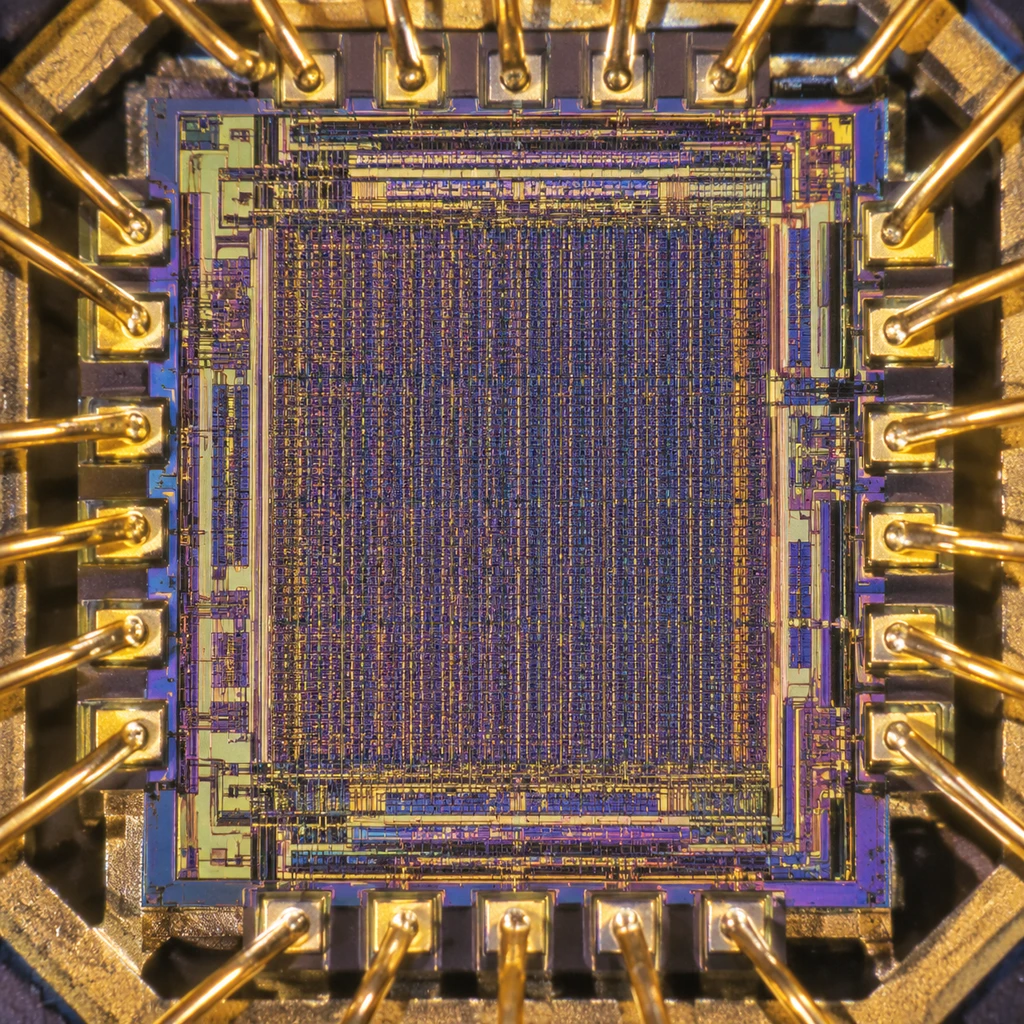
在硅片面积连一条多余总线都容不下的 1980 年,Intel 海法团队为了塞下 1,648 条 16 位微指令,甚至发明了多尺寸晶体管,在微码 ROM 里实现了单单元存储 2 比特。
当硬件电路上省无可省,微码就成了唯一的障眼法道具。
比如浮点缩放指令 FSCALE。按规范,它需要读取底数 ST(0) 和缩放幂次 ST(1)。正规架构理应配备双操作数读取总线,但 8087 偏不配。
它的微码在执行时上演了一出手彩:微指令先发一个假弹栈命令,把栈指针 TOP 强行挪一位,使物理上的 ST(1) 瞬间变成逻辑栈顶 ST(0),读入暂存器后再立即压栈复原。靠着控制流欺骗内部寄存器堆,直接省掉了第二操作数总线的硅片布线。
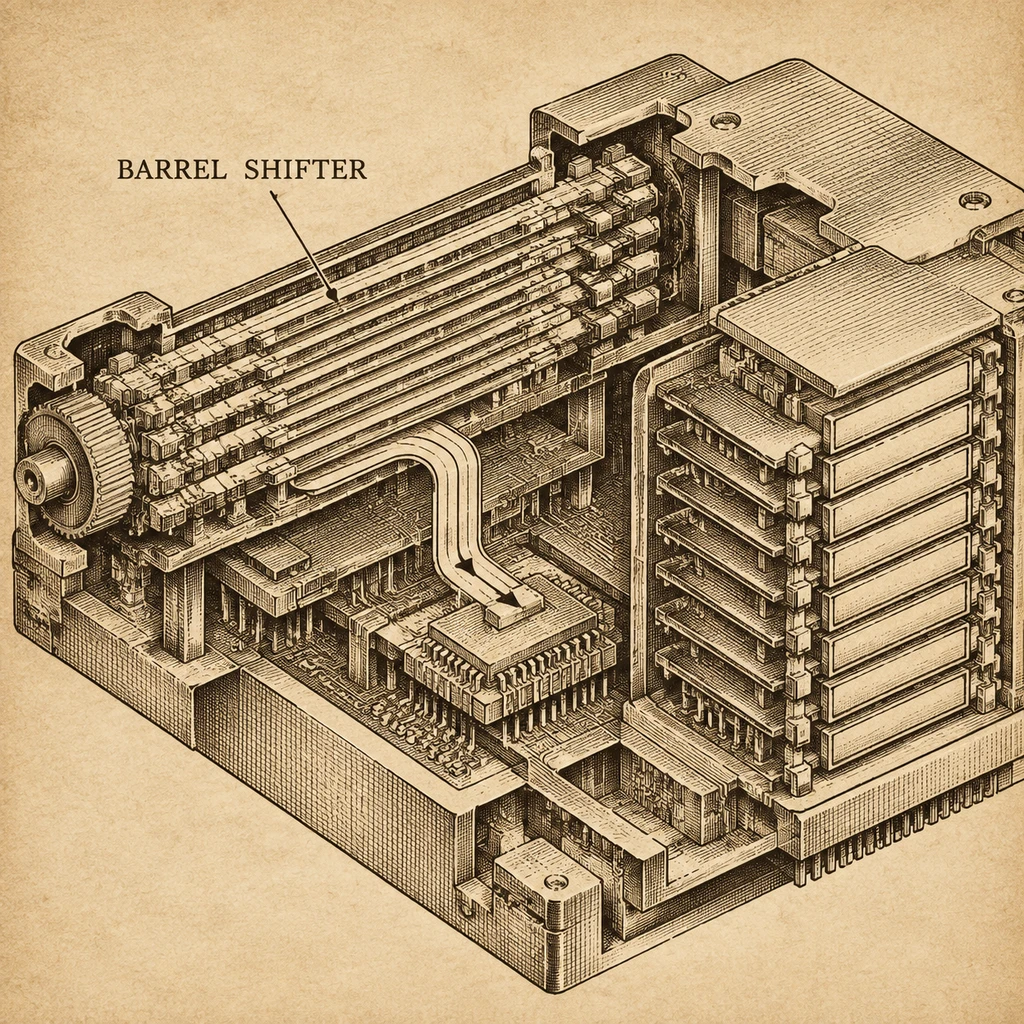
紧接着,因为幂次传入的是 80 位浮点实数,微码必须先将其截断为整数。芯片内部没有指数截断电路,微码便公然跨通路借力,调用原本专门伺候乘除法的 68 位尾数桶形移位器,把指数强行对齐移位,榨出整数后再扔回 16 位加法器。
如果说微码偷道只是片内消化,那么在正切指令上,硬件团队直接把成本转移给了全世界的程序员。
初代 8087 的指令集里,正切指令被命名为部分正切 FPTAN。许多程序员困惑多年:为什么它算完后不直接给一个标量,而是依次在栈里压入 $Y$ 和 $X$ 两个数?上层调用者必须自己手动紧跟一条 FDIV 做除法。
显微镜给出了最残酷的解释:芯片内部算完 $3r / (3-r^2)$ 后,分子正好落在 $Y$ 向量,分母落在 $X$ 向量。片内微码已经没有多余的时钟和逻辑来跑完除法,工程师干脆把未加工完的双值直接扔给调用栈,让外部软件来扛这一刀。
不仅如此,8087 硬件根本不做通用角度规约。输入的角度必须严格卡在 $0 \le |\theta| \le \pi/4$。一旦超出区间,硬件直接罢工,程序员在调 FPTAN 前必须手动调用 FPREM 把输入切碎。
这笔历史借债一直欠到 1987 年的 80387。到了 386 时代,晶体管充裕,Intel 才全面推倒这套混合微码,换上大查找表和硬件乘法阵列。为了维系老软件的调用栈兼容,微码只能在算完后硬压一个常数 1.0 进去陪跑。
泥潭里挣扎出来的标准基石
《考工记》有言:知者创物,巧者述之守之,世谓之工。
现代教科书最大的误区,在于总试图将历史描摹成自上而下的真理降临。但看一看真实的时序便知:8087 投产于 1980 年,而著名的 IEEE 754 浮点标准正式颁布是在 1985 年。
时序不可倒置。不是 8087 实现了 IEEE 754,而是数值分析大师 William Kahan 带着 8087 这颗粗糙、充满妥协、甚至带着未规格化数历史包袱的实体硬件,去逼迫全行业收敛。
在标准立案前,DEC、IBM 各家自说自话,浮点计算连舍入规则都不兼容。8087 率先把 80 位扩展精度、NaN 非数和细粒度异常做进了芯片。它带着一身手工业时代的补丁抢跑了整整五年,成为了事实上的标准样板间。
这场逆向工程给现代开发者划出了极其现实的边界:
对于 DOSBox、86Box 的模拟器作者,搞清 16 步 CORDIC 和 Padé 混合截断,意味着终于能完美复刻古董 CAD 软件在特定弧度下的精度漂移,修复那些埋藏几十年的边缘 Bug。
对于超低功耗边缘芯片与 FPGA 设计者,这套混合架构更是直接翻盘的图纸。当制程红利见顶、功耗和门电路预算重新变紧时,先用十几步廉价移位咬掉绝大部分动态范围、再用一道低阶多项式收割残差的策略,比无脑堆砌硬件乘法阵列高明得多。
学术论文喜欢追求闭式解的对称与无瑕,但工业界要的是在 5mm×6mm 的泥潭里把产品做出来。
四十年前那些躺在显微镜下的工程师,没有专用乘法器,没有充裕的 ROM,连栈指针都要靠骗。但这不妨碍他们用 4 万只晶体管,把整个个人电脑产业推进了科学计算时代。