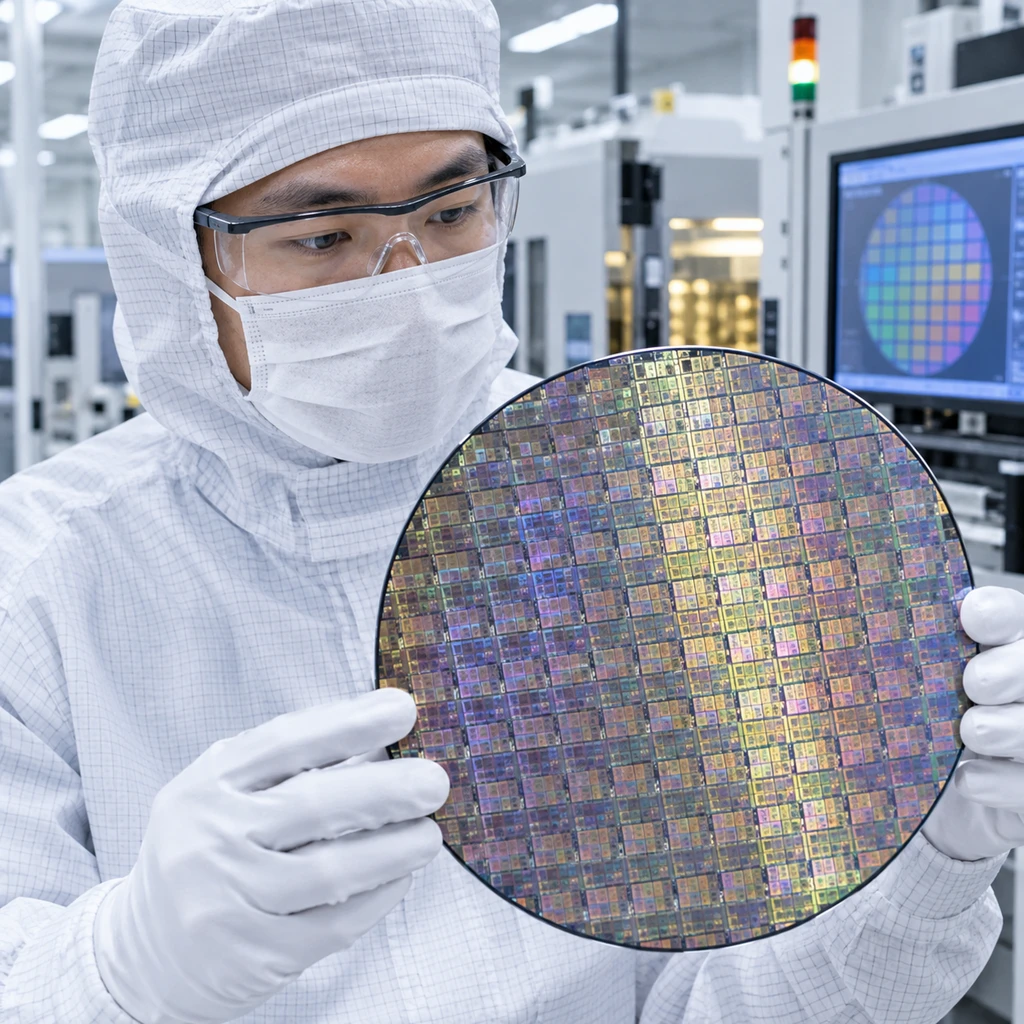
新思科技在 2026 年 9 月 30 日与 OpenAI 签下一纸多年期战略合作,正式拿出芯片设计专属模型 GPT-Synopsys。
两家公司打破了半导体工业软件沿用四十年的固定席位授权制,改成把 OpenAI 的云端算力、模型推理与新思科技的 EDA 工具打包出租,再按业务收入分成。技术层面上,GPT-Synopsys 抛弃了以往靠通用模型生成辅助脚本的外挂做法,直接让模型接管底层工具链,自主解析时序报告与物理版图检查。
这笔交易没有公开任何标准化的实测跑分,也没有竞品基准对照,全行业通用交付日期同样只字未提,目前只向少数选定的半导体客户开放测试。
消化10吉瓦自研芯片,软件巨头反向造铲
看懂这桩合作,必须先算清 OpenAI 自己的算力账本。
这家软件公司早已同博通签下高达 10 吉瓦的自研 AI 加速器部署协议。双方联合研发的首款定制推理 ASIC 芯片 Jalapeno,把面积做到了光罩极限尺寸,整个开发周期压缩在 9 个月之内。按照规划,首批机架在 2026 年下半年就得进场,全套 10 吉瓦集群必须在 2029 年底前全部交付。
买英伟达现成 GPU 只能解燃眉之急,自研 10 吉瓦芯片才是它的核心底牌。面对这种量级的硬件迭代,单纯向博通提需求已经不够用,OpenAI 必须自己把手插进半导体设计最底层的工具链。
工程师过去使用通用模型写 Python 或 Tcl 脚本,生成之后还得人工复制进环境跑,跨工具的上下文极易脱节。GPT-Synopsys 把大模型接进 Synopsys.ai 和 Autopilot 内部接口,根据反馈多轮调整,把原先散乱的单向输出收拢成自动化工程循环。
阵营割裂背后的指标断层
芯片自动化工具市场常年由三巨头垄断,阵营分化在这一轮合作中愈发明显。
Cadence 选择倒向英伟达,基于 Nemotron 模型推出 ChipStack,宣传可在物理设计流程中达成 5 至 10 倍加速,并在特定场景优化 20% 的性能、功耗与面积指标。西门子 EDA 同样采用英伟达架构,推出 Fuse 智能体方案。
三家工具商都在宣传惊人的效率倍数,但前端工程提速与芯片实物收益存在巨大脱节。
Cadence 在 Altera 项目中压减了 10 倍验证工作量,但在 Imagination 的 5 纳米 GPU 上,最终总功耗降幅仅有 6%;在三星 SoC 项目中,综合收益也只有 8% 到 11%。新思科技自己的 DSO.ai 在早期测试里提速 3 倍,实际功耗优化上限同样卡在 15%。
学术界在 ChiPBench 测试中早就挑明了这一现实:模型在设计早期阶段展现出的布线与时序改善,进入最终 Sign-off 签核环节时极容易彻底失效。哪怕把文本测试集跑满,只要换到调用真实工具链的物理评测里,算法就会立刻现出原形。
屏幕上省下的几千人工时,掩模版和良率表统统不认。
审查重负与物理铁律
大模型没有消灭芯片工程师的劳动,而是把他们推向了更头疼的审查岗位。
软件开发面对 85% 的可用率就能上线迭代,半导体物理世界却要求绝对的零缺陷。先进制程单次流片费用动辄数千万美元,《韩非子》讲“千丈之堤,以蝼蚁之穴溃”,芯片制造正是这种不容半分差错的行当。
日常验证中,大模型很擅长写出语法挑不出毛病的随机化约束用例。看似逻辑自洽,一旦包含隐蔽的边界条件疏漏,就会掩盖真实电路缺陷,把致命错误一路送进流片产线。证明一段机器生成的代码完全没错,往往比工程师自己重写一遍还要消耗心智。
更现实的阻碍是数据主权。半导体公司的 RTL 源码、时序约束与晶圆厂的制程设计套件(PDK),属于各家保密级别最高的命脉资产。即便 OpenAI 声称数据加密且不参与后续模型训练,要把这套核心机密上传到第三方的托管云环境,主流代工厂和芯片设计商在采购签字前都会停步掂量。
OpenAI 需要拉拢新思科技来向资本市场证明工业级推理能力,并靠工具分成做大收入;新思科技则要在英伟达同盟的逼近下守住估值底线。两家各取所需,但接下来的胜负手不在商业协议多体面,而在未来 12 到 24 个月内,究竟能不能拿出一颗真正跑通完整签核并成功量产交付的芯片。