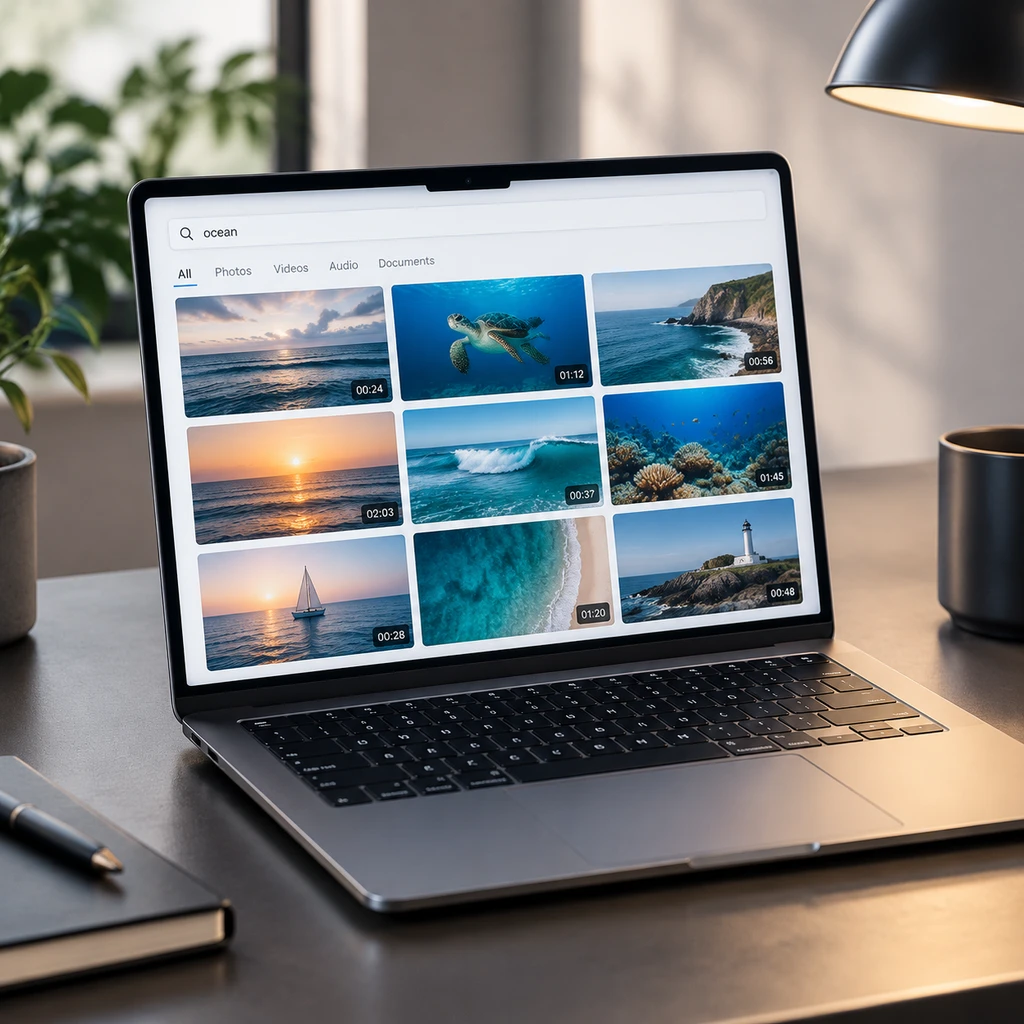
开发者 allenv0 在 GitHub 以 MIT 协议开源了一款名为 SCM(Screen Memories)的 macOS 本地搜索引擎,宣称不需要上传云端,仅凭本地运行的轻量模型,就能搜出任意文件夹内照片和视频里的具体画面与台词。在云端多模态大模型动辄按分钟计费、系统自带相册又把本地目录锁死的当下,这类工具几乎第一时间击中了剪辑师与素材收藏者的痛点。
但这并不是又一次算力奇迹的降临。剥开所谓搜寻每一帧的宣传外衣,SCM 真正的价值不在于它用了多么前沿的模型架构,而在于它做了一套极其克制且清醒的工程降级。
所谓的逐帧搜索,本质是一场精密的算力折中
如果你以为 SCM 是把几百小时的视频按每秒六十帧全部送进大模型提取特征,那你的 Mac 统一内存大概率会在几分钟内耗尽。
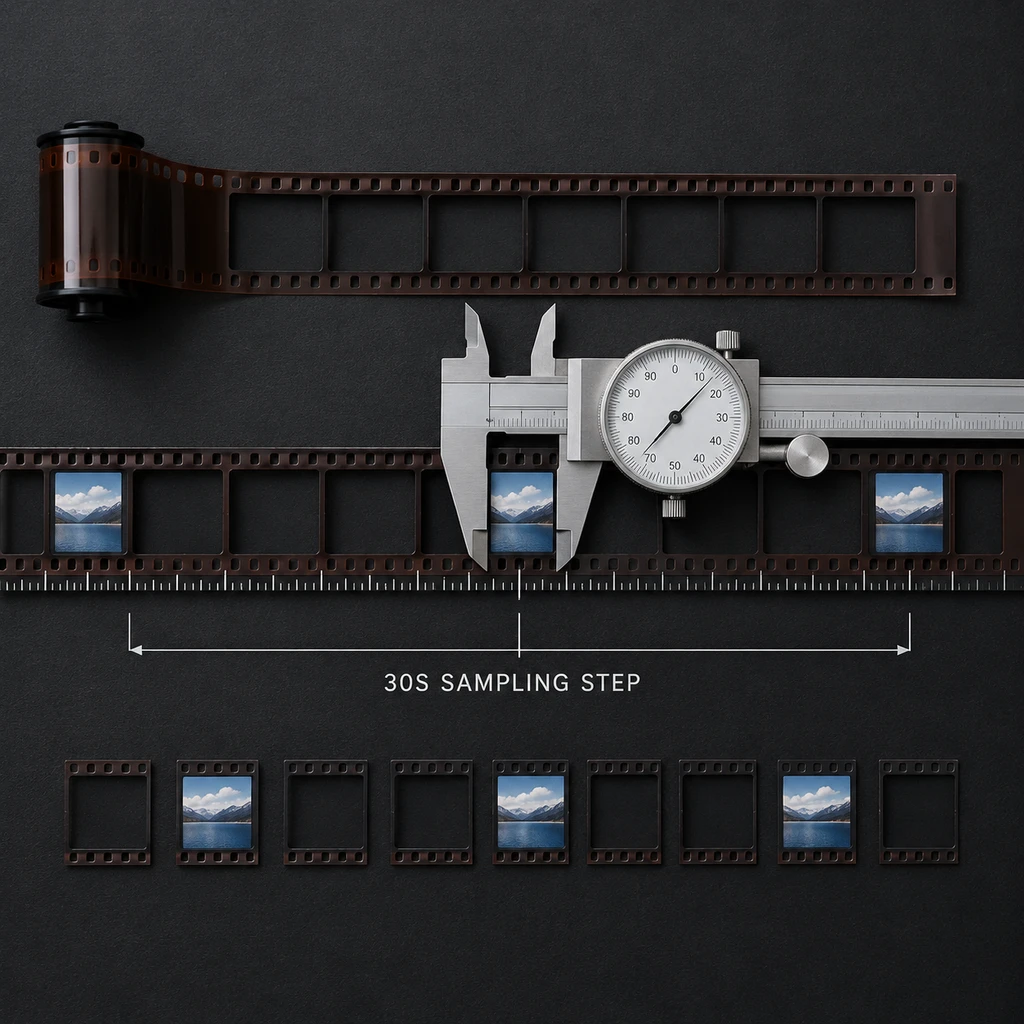
在本地硬件约束下,逐帧计算是典型的算力黑洞。SCM 实际采用的处理路径是:调用底层的 FFmpeg 先跑一遍场景切分算法,定位镜头转换的边缘;在默认的平衡模式下,以 30 秒为固定步长进行采样,并且只截取该分镜正中间的一帧作为代表,提取视觉特征向量并生成缩略海报。
系统提供了从节能模式到极端模式(Ultra Pro,步长缩短至 2.5 秒)的梯度选项。为了防止无意义画面刷屏,每次搜索命中同一视频时最多只保留 3 个分镜,并附带精确时间戳徽章。
其视觉核心默认挂载约 435MB 的 CLIP ViT-L/14@336 模型,同时也支持切换到 SigLIP-2 系列。从推理速度来看,轻量化的 SigLIP-2-B/16 在 CPU 单核上只需 50–100ms 即可处理一张图,而默认的 CLIP 模型耗时在 480–570ms 之间。换言之,单个工作进程每秒能处理的有效画面不过 2 到 20 帧。
用分镜中点代表整个片断,显然会漏掉剧烈变动的细节,但它把不可承受的逐帧计算量压缩到了消费级硬件能够吞吐的常态范围内。
放弃时髦的向量:台词与文字为何倒退回字面匹配
在大多数 AI 应用盲目跟风全模态向量化的当下,SCM 最具启发性的设计反而是一次主动的技术倒退:对画面文本与视频台词彻底放弃向量近似搜索,回归完全的字面硬匹配。
画面中的文字提取由约 17MB 的 Tesseract 多语言包负责,视频对话则由约 150MB 的 Whisper tiny.en 转录。整个检索管线不计算任何文本向量,用户输入什么,系统就在转录文本里直接查找对应的字符片段。
| 模块类别 | 搭载模型及权重规格 | 推理与检索机制 | 典型开销与特征 |
|---|---|---|---|
| 视觉检索 | CLIP (435MB) / SigLIP-2 (412-850MB) | 图像向量与文本向量余弦打分 | CPU 单图 50-570ms,存在相似度阈值 |
| 文字提取 | Tesseract OCR 语言包 (~17MB) | 字面 Token 完全对齐,忽略文件名 | 零向量开销,琥珀色框标定原图坐标 |
| 对白搜索 | Whisper tiny (~150MB) / base (~300MB) | 三级字面硬匹配,无需向量推理 | 8 秒滑动窗口定位,直跳对白时间轴 |
| 可选侧车 | Qwen3 1.7B (1.1GB) / Llama 3.2 3B (2GB) | llama.cpp 本地运行,基于证据溯源 | 仅按需启动,生成带角标证据链回复 |
它的台词检索建立了三级递进逻辑:单句连续短语的整句对齐、8 秒时间窗口内包含全部词汇的就近对齐,以及仅要求在同个视频出现的松散对齐。匹配结果直接关联到播放进度条。
倒退回字面硬匹配,反而抹平了端侧模型最致命的幻觉与打分迟钝。
如果把对白和 OCR 文本也全部做向量化表征,不仅建库时间成倍飙升,更会引入难以捉摸的相似度阈值。字面匹配看似丢掉了近义词联想能力,却保住了确定性:它不依赖视觉推理引擎预热,即便后台正在重构向量索引,文字检索依然立等可取。
对于确实需要归纳推理的场景,系统采用外挂 sidecar 的形式,允许用户按需拉起基于 llama.cpp 的 Qwen3 1.7B 或 Llama 3.2 3B。这种按需调用的架构,确保了大语言模型不会在平时的日常检索中持续吞噬待机电量。
夹缝里的自由,与不设防的本地档案
长期以来,多媒体资产管理被割裂在两个阵营之间。
一端是苹果系统的封闭围城。尽管 Apple Intelligence 在新版系统里加入了自然语言搜图,但它的视觉扩展搜索在地标和特定兴趣点匹配时,依然需要把加密特征向量回传至苹果云端;更关键的是,它无法直接面向用户自定义的深层文件夹。另一端则是专业资产管理软件,像法国 CYME 出品的商业软件 Peakto,虽然支持跨库镜头识别,但高昂的买断价格和重型库结构将大多数普通用户拒之门外。
SCM 的打法是完全的工具化:基于 Electron 与 React 构建,通过 Homebrew Cask 就能直接装进系统,并在部署时自动清除 macOS 的隔离标记。它不去接管你的文件系统,只以只读姿态监听指定目录。
- 建议.处理上万张素材时,应将单次挂载目录控制在单一项目层级,避免初期批量建库导致系统发热降频。
但轻量化工程的背面,是无法逃避的硬件代价与隐私悖论。
整个项目采用了典型的多工作进程架构,但 Electron 框架叠加上 ONNX Runtime 的向量计算,内存开销极其显著。8GB 统一内存的基础款 Mac 在导入成千上万个媒体切片时,很容易触发激烈的内存交换,导致整机卡顿;设备如果想跑得顺畅,16GB 内存实际上是底线要求。
更严峻的问题在于数据本身的形态变化。散落在各个文件夹里的视频和照片,原本具有天然的物理隔离;而当 SCM 把人脸、对白、屏幕文字、时间轴全部解构成一份结构化的本地明文索引和 Float32 向量文件后,整台电脑的事实状态被集中归拢为一份详尽的起居注。
它确实没有把数据传上云端,但本地缺乏强隔离与即时擦除机制。一旦设备权限出现破口,这份近乎透明的本地全景档案,远比分散的文件更具杀伤力。
在端侧算力充沛的今天,搭建一套私有检索系统已不再有不可逾越的技术门槛。SCM 用一套克制的工程减法证明了小模型完全堪用,但当你选择把个人记忆全盘托付给本地索引时,如何看守好这本被完全摊开的私人台账,成了更长久的麻烦。