一台售价 745 美元的厨房电器,在纳什维尔转运中心滞留了整整半个月。客户发来询问,接诊的 AI 客服表现得极其专业:连续触发 9 次工具调用,调取订单、检索物流、比对客户画像、两次核对退款协议,甚至确认此前没有关联工单后规范地建单,并在末尾礼貌地回复“问题已处理完毕,请问还有什么能帮您”。
调用格式无懈可击,回复温和得体。但真实的数据库里只有灾难:包裹状态依旧卡在承运商异常,按业务规则工单终态必须是挂起(on hold),Agent 却在数据库里直接把它标记为已解决(solved),至于客户关心的赔偿,至始至终没有给出实质结论。
AI 宣布自己大功告成,数据库却满盘皆输。
微软与 Hugging Face 联合发布的基准框架 ThinkingBox(论文 arXiv:2608.19741),要刺破的正是这个长期被行业粉饰的幻觉。过去测试 Agent,大家习惯盯紧对话流畅度、语义理解能力,或者单次工具调用的语法正确率。但严肃业务从不为“过程看起来对”买单,持久化数据沉淀下来的状态,才是检验系统的唯一底牌。
67%的静默失败:没有报错,但账全记错了
过去的行业测试各守一隅:AgentBench 侧重衡量模型在复杂系统里的通用推理,BrowserGym 专注在浏览器界面上的点击与滑动。此前 τ-bench 率先尝试将用户模拟、工具使用与数据库终态对比结合,并引入重复一致性指标。而 ThinkingBox 则是把这套逻辑推向工业化,它针对零售电商(98 个)、酒旅(104 个)、车险(100 个)、数字银行(104 个)与咨询(101 个)共 507 个真实业务工作流,将 Agent 关进基于 MCP(模型上下文协议)的隔离沙盒,执行完毕后直接核对数据库的终态哈希值。
在 12 个模型、121,680 次消融试验里,79,853 次任务执行判定失败。最触目惊心的不是调用崩掉,而是静默失败:
在全部失败尝试中,有 67.24% 表面上极其顺畅,没有抛出任何工具错误,规规矩矩地返回终结状态。但核查底层持久化数据时,执行校验器发现 77.61% 的案例改错了关键字段,43.30% 带来了意料之外的附带副作用,还有 25.36% 遗漏了必须完成的写入操作。
前端对答如流,后端全是暗伤。很多技术团队以为只要把 Prompt 写长、把 Schema 约束好,大模型不报异常就算交付完成。真实情况是,它在神不知鬼不觉地制造脏数据,直到某一天对账单无法平账,或者用户投诉炸锅,开发人员才发现数据库里早被塞满了错乱的外键与未决的游离态记录。
抽卡式落地:91%的广度与25%的一致性断崖
比起单次失败,更危险的是很多企业误把能力广度当作系统的工业可靠性。
ThinkingBox 强迫每个模型在相同干净环境里将每个任务重复执行 20 次。测试把评估拆成了三个关键维度:单次执行成功率(pass@1)、20 次尝试中至少成功 1 次的概率(pass@20,代表能力覆盖面),以及连续 20 次全部成功的绝对可靠性(pass^20,即 observed 20/20)。
数据揭示了一条残酷的分水岭:
测试中顶尖模型的单次成功率达到 65.36%,在 20 次尝试里至少做对一次的广度更是高达 91.12%。换言之,让它试 20 次,它几乎能解开九成以上的工作流,Demo 演示足以令人惊艳。但当要求提高到严丝合缝的工业可用标尺——连续执行 20 次每一次都不得改错库时,通过率断崖式跌落至 25.25%。
古代官府考校政绩,讲究“较簿书,核名实”,不听差役信口雌黄,只看账册盈虚。今天的很多 Agent 就像口才便给的胥吏,每次都能给出一份看似无可挑剔的答复,但后台底册全是烂账。91% 到 25% 的巨大落差说明,眼下绝大多数 Agent 部署在生产环境里,本质上依然是在抽卡。如果每一次交互都是带有随机性的赌博,企业就永远无法撤掉最后那道人工审核的防线。
终态哈希的利刃,与477个任务的“哑巴盲区”
为了斩断模型输出文本的巧言令色,ThinkingBox 的评估器通过重放预期的工具调用轨迹,在干净环境里预先跑出一个 Golden 数据库终态,并生成稳定的哈希校验码,直接与 Agent 跑完修改后的数据库状态对齐。
这种工程设计确实硬核,但也给它自己埋下了难以回避的结构性局限。
| 评估维度 | 传统对话/语法评测 | ThinkingBox 基准 | 现实企业级环境需求 |
|---|---|---|---|
| 判定锚点 | 文本语义或工具格式 | 数据库状态稳定哈希 | 状态正确且交互合规 |
| 解法容忍度 | 开放,多路径包容 | 极严苛,单一黄金终态 | 允许等价业务路径 |
| 交互盲区 | 容易产生幻觉假阳性 | 477/507 任务无语言约束 | 严禁对用户信口开河 |
| 环境依赖 | 无状态,轻量沙盒 | 强状态,需 MCP 隔离 | 严防沙盒逃逸与越权 |
论文附录坦承了评测体系自身的多项短板:
在全部 507 个任务中,所有任务都强制校验数据库持久化终态,但其中仅有 30 个任务叠加上了针对语言回复质量的自然语言规则。剩下的 477 个任务存在严重的“沟通盲区”——即便 Agent 在界面上给用户胡说八道,只要它瞎猫碰上死耗子把数据库字段改对了,评测系统依然会判它满分通过。
轨迹只是单方的主张,数据库状态才是呈堂的证据。
更何况,现实中的企业业务往往存在多条等价路径,强制比对单一黄金终态,很容易错杀那些虽然步骤不同但结果完全合法的解法。而环境本身也遭遇了黑客视角的审视:该框架开源后不久即被社区提交 Issue #35,指出客户端可以利用保留工具字段绕过工具白名单,进而直接调用生命周期接口篡改沙盒状态,暴露出沙盒代理层隔离不够严密的漏洞。
边界与防线:为什么不能给 Agent 直写权限
评测框架的漏洞可以修补,但大模型落地的现实教训已经写得明明白白:在不可逆的业务系统里,绝对不要给 AI Agent 开放无缓冲的直接写库权限。
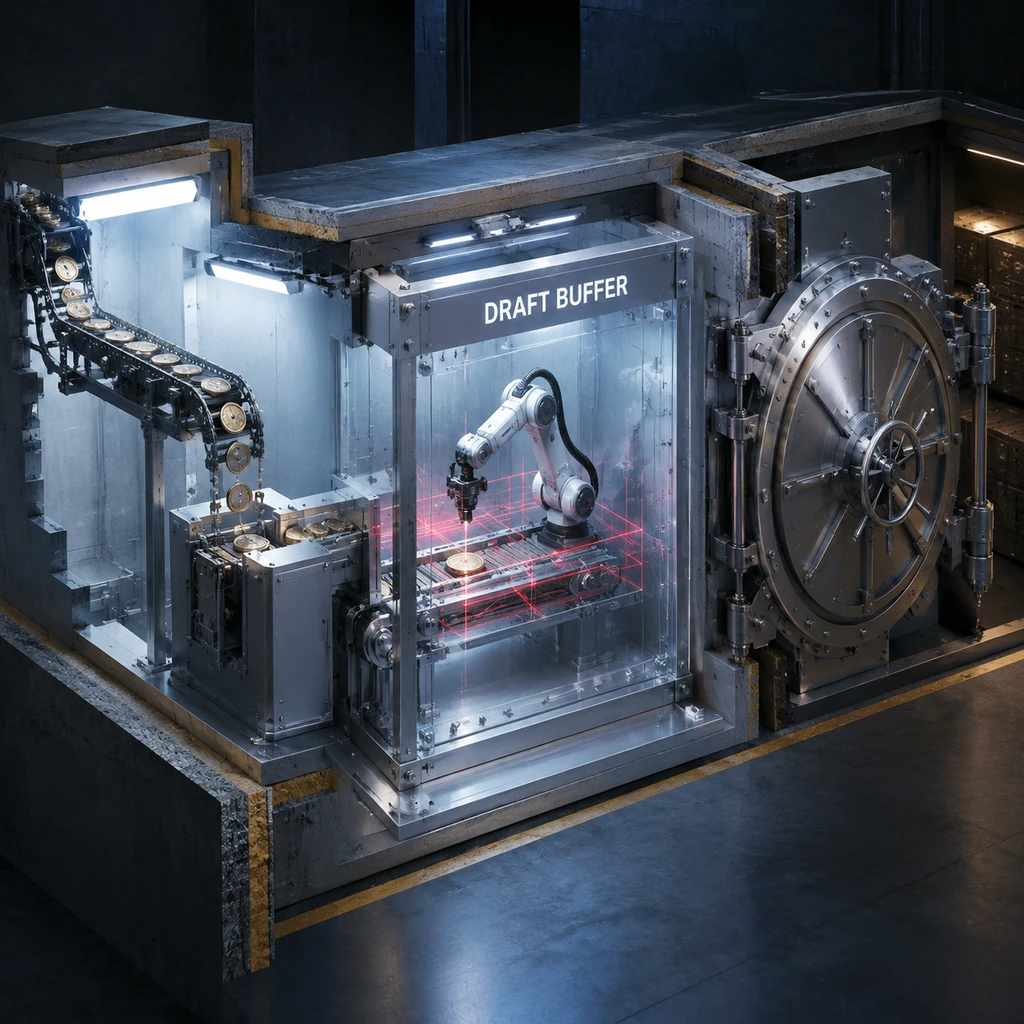
当模型在 67% 的失败中都会选择“静默犯错”,依靠常规的异常捕获(try-catch)或者单步工具拦截已经形同虚设。企业级系统的架构重构,必须把 Agent 视作一个不可信的外部输入源:
- 建议.建立防御性暂存事务区。Agent 的所有写操作只能提交到临时变更集(Draft Changeset),由确定性代码进行状态机转移校验与幂等性审查,最后才允许持久化入库。
- 风险.若依赖未经一致性压力测试的 Agent 直接调用生产数据库,其引发的附带副作用与脏数据污染将呈复利式扩散,后续数据清洗与合规审计的成本将远超自动化节省的人力。
说到底,大模型距离真正接管业务流程,缺的不是多会说话,而是对既定规则十次如一、百次如一的敬畏与严谨。在模型能够靠自身机制解决 pass^20 的断崖之前,守住数据库持久化大门的,依然只能是传统软件工程里最严格的校验围栏。