人工智能资讯 第38页
聚合当前分类下的最新内容,按时间顺序查看第 38 页精选文章。
GLM-5.3宣布开放权重,但Hugging Face先出现的只有Flash版
GLM-5.3宣布开放权重后,发布当天可下载的却主要是Flash版,完整版权重、上线时间和许可边界仍不清楚。它适合开发者先做技术验证,但还不足以支持企业迁移或采购决策。把“开放权重”直接写成“开源”,会掩盖版本、许可证和可复现性之间的差距。
OpenStreetMap 2026:地图社区开始认真追问,AI拿走数据后谁来分配价值
OpenStreetMap State of the Map 2026将在巴黎地区举行,会议议题把AI数据使用、社区回馈和志愿者成本推到台前。真正的争议不在于OSM要不要拥抱AI,而在于开放数据被大规模商业化之后,贡献者还能否看见回报、获得控制权。
OpenAI泰国加速器:细节全在通稿里,官网查无此项
OpenAI与泰国MHESI宣布成立AI加速器,首批10家初创公司入选,8周内拿2000美元API额度冲刺产品化,11月曼谷开Demo Day。但泰国政府侧官网目前查不到对应的独立确认页面,这场政企合作更像是OpenAI单方叙事,而非双方对等公示。
三个“正确无害”的PR被秒关:GitHub贡献图正在被AI刷穿
一名几乎没有贡献记录的用户,靠Claude代写代签,连发三个纯改typo的PR,被维护者Neil Alexander全部关闭不予置评。curl的数据显示这不是孤例:约20%的安全报告是AI生成的水货,只有5%是真漏洞,倒逼GitHub半年内连续推出六项治理工具。但curl后来的经验也说明,AI本身不是敌人,没人负责的AI产出才是。
科学AI基准的自曝裂缝:920选70,Opus 5也只拿30%
Stanford团队联合多学科科学家发布Terminal-Bench-Science 0.1,920个任务提案筛到只剩70个,最强的Claude Opus 5解决率也只有30%。真正值得看的不是这个分数,而是基准公开评审记录里自己承认的容差争议和二元评分缺陷。
19.9毫秒背后:这个「开源OpenRouter」自曝了一个30请求/秒的天花板
开源项目Experiential在Hacker News自称「开源版OpenRouter」,卖点是把生产流量炼成更好的路由器甚至专属模型。但它自己发布的深度benchmark显示,无论走Rust还是Python引擎,最终都会撞上SQLite同步写入天花板,单进程吞吐被锁在每秒30到50个请求;它最有想象力的卖点目前唯一公开的证据,也只是一次本地确定性模拟,官方自己都写明不能代表真实托管环境的质量。
机械臂8小时接完实验室,Anthropic的'硬件标准'其实还是申请制预览
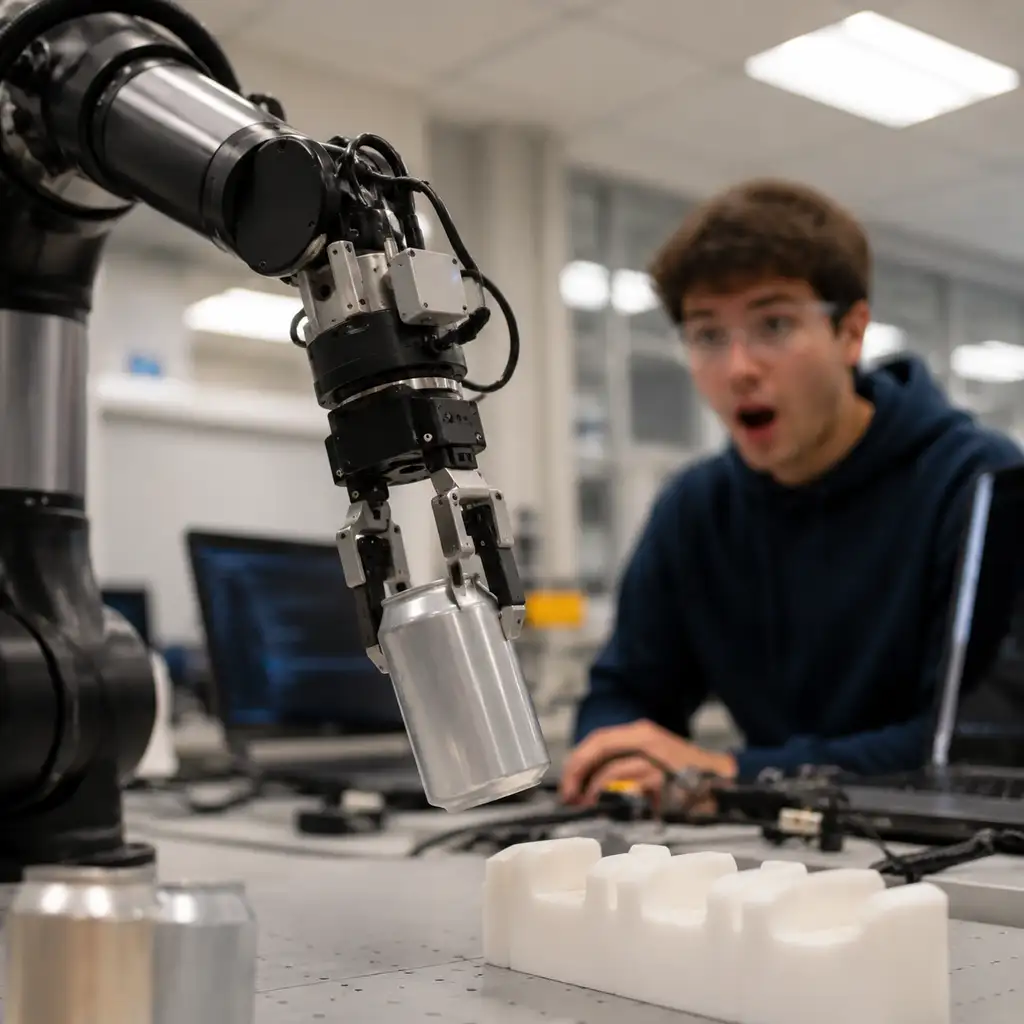
Anthropic发布Model Hardware Standard,想让AI agent直接操控机械臂、显微镜等实验硬件,CMU等案例显示集成效率大幅提升。但官方材料自己承认,这套东西尚无公开规范、安全审计和开源时间表,泡沫误判案例也暴露了agent的物理常识短板。
Barret Zoph转投Google:AI顶尖人才开始在大厂与创业公司之间回流
Thinking Machines Lab联合创始人兼前CTO Barret Zoph在短暂回到OpenAI后,现已加入Google。他从Google Brain出发,又回到Google,说明顶尖AI人才的竞争已从单向挖角变成大厂、创业公司之间的反复回流;但其具体职位与对Gemini的影响仍未公开。
买过才能用:Google把书接进了AI笔记本
Google给Gemini Notebook加了Expert Intelligence,首批接入超10万本已购图书,可问答、生成计划、信息图和AI播客,15位作者参与定制笔记本。购买鉎权解决了谁能看的问题,却没说清数据是否用于模型训练、作者和出版社怎么分账——这才是真正要盯的变量。
77篇论文里出现了不存在的作者,学术出版的漏洞比AI更先暴露
一份调查发现,至少77篇论文出现了疑似并不存在的作者姓名,包括 Elena Vasquez、Marcus Chen 等。真正危险的不是模型会编名字,而是期刊、索引和审稿流程竟然能让这些名字一路进入正式记录。
这只AI狗碗号称能提前测出蜱虫热,但它自己的官网先打起了架
Palo Alto创业公司Hoomanely推出智能喂食站EverBowl,靠AI分析狗的进食饮水行为提前预警疾病,已获180万美元pre-seed融资。但公司官网上关于beta测试规模、订阅定价、准确率的说法互相矛盾,暴露出早期消费医疗AI在证据和营销之间的落差。
luna降价八成,小模型的"够用论"该信几分
OpenAI的小模型gpt-5.6-luna今年被官方降价80%,跑一次复杂研究任务只要几十美分,让"小模型够用"的说法流行起来。但它宣传的百token每秒速度只对企业付费模式生效,而两套权威跑分对小模型和旗舰模型的差距给出了相反答案,说明"够用"高度取决于任务类型,不是一句话能定论的。
72%青少年用过AI陪伴,钥匙却在别人手里
记者Bridget Todd在父母去世后不知不觉从用ChatGPT查医疗资料变成向它倾诉情绪,这一经历促成她的新书《Love at First Prompt》。多项研究显示,这种"滑入陪伴"是规模化的结构性现象,真正问题不是用户是否孤独,而是这段亲密关系由谁拥有、谁能随时改写规则。
40秒视频要花多少钱:Gemini Omni 1.1 Flash的账没写进通稿
Gemini Omni 1.1 Flash主打场景延伸、首尾帧插值和4K升采样,官方称其“生产就绪”,但按官方计费拆解,40秒延伸视频输出成本已近4美元,且开发者发布当天就在GitHub和Reddit上报出架构迁移、身份漂移和安全过滤器黑箱一堆麻烦。控制力升级是真的,账本和bug列表也是真的。
ChatGPT让论文涨0.86分,但批判性思维训练几乎白搭
OpenAI与博科尼大学的随机对照实验显示,拿到ChatGPT的学生评分从2.09分跳到2.95分,统计显著;但专门训练批判性思维的学生评分几乎没变,收益全部体现在评分表测不到的创意多样性上。这说明官方所说的'AI与批判性思维互补',在传统评分体系里更像是AI单独起效,训练的价值被现有评估标准系统性低估。
AI耗水争议:那个被疯传的数字,可能一直找错了嫌疑人
美国数据中心抗议不断,但被反复引用的“2023年660亿升冷却耗水”其实统计的是全部数据中心,不是AI专属;更关键的是,发电环节的间接耗水规模比这高出一个数量级,真正该盯的是电力结构而非机房里的水管。
黄仁勋又喊"实现AGI",转头自己说这词没意义
英伟达CEO黄仁勋在2026年8月的财报电话会上说,公司"对许多任务"已经实现AGI,话音未落又称这类里程碑"没有意义"。这不是一次可验证的技术宣告,而是把AI竞赛的评判标准从模糊的AGI名号,换成了能不能把算力变成利润。
Google AI Mode能订机票酒店了,但它不想当“旅行社”
Google给AI Mode加上了追踪机票、预订酒店、显示积分里程价格三项新功能,看起来像一个全能AI旅行代理。但细看合同条款会发现,Google在交易里刻意不做“交易方”,责任上限只有200美元,这和它对外营销的“旅行助手”形象并不一致。
Waymo暗讽Tesla“摄像头不够”,可它自己也没做过对照实验
Waymo在技术博客里甩出2.206亿英里的安全数据,暗讽Tesla纯视觉路线不够用,但这组数据证明的是整套系统的表现,而非激光雷达单独的功劳。更关键的是,双方目前引用的评价标准根本不在同一套体系里,这场“摄像头够不够”的争论还停留在理念声明阶段。
Cocomelon的AI操作手册:护栏是给律师看的,未必是给画师看的
Moonbug被曝要求Cocomelon等品牌的动画师开始试用AI,内部《Studio AI Bible》详细规定了能做什么、不能做什么。规则表面在保护艺术家的创作主导权,实际逻辑更接近保护公司的版权可辩护性——而政策没提的,是今年5月刚发生在自家片场的罢工。
商家扎堆手写"拒绝AI"标语走红,广告业却读错了一组数字
一批商家、酒吧、图书馆用手写便签宣称拒绝AI宣传,在Instagram收获数万点赞。多份2025-2026年消费者调查显示,这背后不是段子,而是可测量的信任落差——82%的广告高管误以为消费者喜欢AI广告,实际只有45%买账。