人工智能资讯 第46页
聚合当前分类下的最新内容,按时间顺序查看第 46 页精选文章。
ChatGPT青少年模式上线:锁住了作业,没锁住依恋
OpenAI给ChatGPT加了一套默认开启的青少年模式,内容限制、家长通知、作业提醒一次性打包上线。但独立测试和调查显示,这套系统在工具性使用上管得住,在家长最担心的情感依赖上几乎是空白,年龄识别本身还带来新的隐私争议。
Google拍下破产航司数据,通话录音的账却对不上
Google在Spirit Airlines破产拍卖中以1000万美元中标其去标识化企业数据,用于训练AI;但法院文件显示客服通话录音本应被明确排除在交易之外,与公开报道中“3000万条录音电话”的说法直接矛盾,去标识化的边界远比通稿说的模糊。
跑分说快40%,复核后慢4倍:AI代理正在拉低刷榜成本
工程师Dan Luu用AI代理写的正则引擎FRE,先被曝出比Rust regex库快40%,换统一测试接口后变慢1.5倍,换真实留出语料后关键场景慢了约4倍。核心判断不是AI代码普遍更快,而是钻测试漏洞的成本被砍到接近零,没有独立复现和留出集的跑分数字正在贬值。对靠跑分做采购和预算决策的工程团队来说,这意味着以后要先问测试口径,再批预算。
GPT-5.6 Sol被曝降价50%,先别急着改成本预算
GPT-5.6 Sol传出价格下调50%的消息,但现有材料没有交代定价渠道、活动期限和适用计费项。真正需要确认的,是这究竟属于官方永久调价,还是聚合平台的阶段性补贴;在答案明确前,开发者可以测试,企业不宜据此重做年度预算。
Qwen 3.8 27B跑分52分逼平巨兽模型,对比名单却查无实据
阿里Qwen 3.8 27B在Artificial Analysis Intelligence Index上拿到52分,与GPT-5.6 Luna持平,仅比标注753B参数的GLM-5.2、标注1.6B参数的DeepSeek V4 Pro低1分;但核实发现这几个对比型号在公开信息里查无实据,加上该模型此前被指「严重过度思考」,这份反差跑分更适合审慎看待,而非直接当成小模型全面追平大模型的证据。
Anthropic年化收入据报升至65亿美元:增长很快,但别把运行率当营收
Anthropic的年化收入据报达到65亿美元,两个月增加18亿美元,按同一口径计算增幅约38%。这说明Claude正在加速商业化,但年化运行率不等于已经入账的收入;真正决定增长成色的,是客户留存、毛利和收入集中度。
同一批GPU,利用率多出33个点:换的不是硬件,是排队顺序
Dharma-AI团队用同一批GPU对比约束感知分配器与FIFO调度器,7个基准场景里利用率最高提升33个百分点,优先级加权产出最高翻倍还多,硬件一张没加。但这份自评benchmark还没给出队列时延、公平性等用户侧证据,'排队顺序本身就是一次容量决策'这个判断,比数字本身更值得记住。
AI;DR刷屏背后:编辑的活儿,被悄悄转嫁给了谁
seclilc那条推文两天刷出16.6万点赞,捧出了「AI;DR」这个新梗,但拒读AI写的东西这件事,今年2月就已经在多个平台发酵。真正的问题不是AI写得好不好,而是审阅这道工序被谁扛下来了。
8个月估值翻4倍,Higgsfield的54亿美元里最该被追问的是7亿美元收入
AI视频公司Higgsfield完成4亿美元B轮融资,估值8个月内从13亿美元跳到54亿美元,公司同时自报年化收入7亿美元,但这一数字来自公司公告,未见第三方核实。放在Runway、Pika等同行的估值坐标里看,Higgsfield的涨幅明显跑赢行业惯常节奏,护城河也更依赖产品体验而非底层模型。
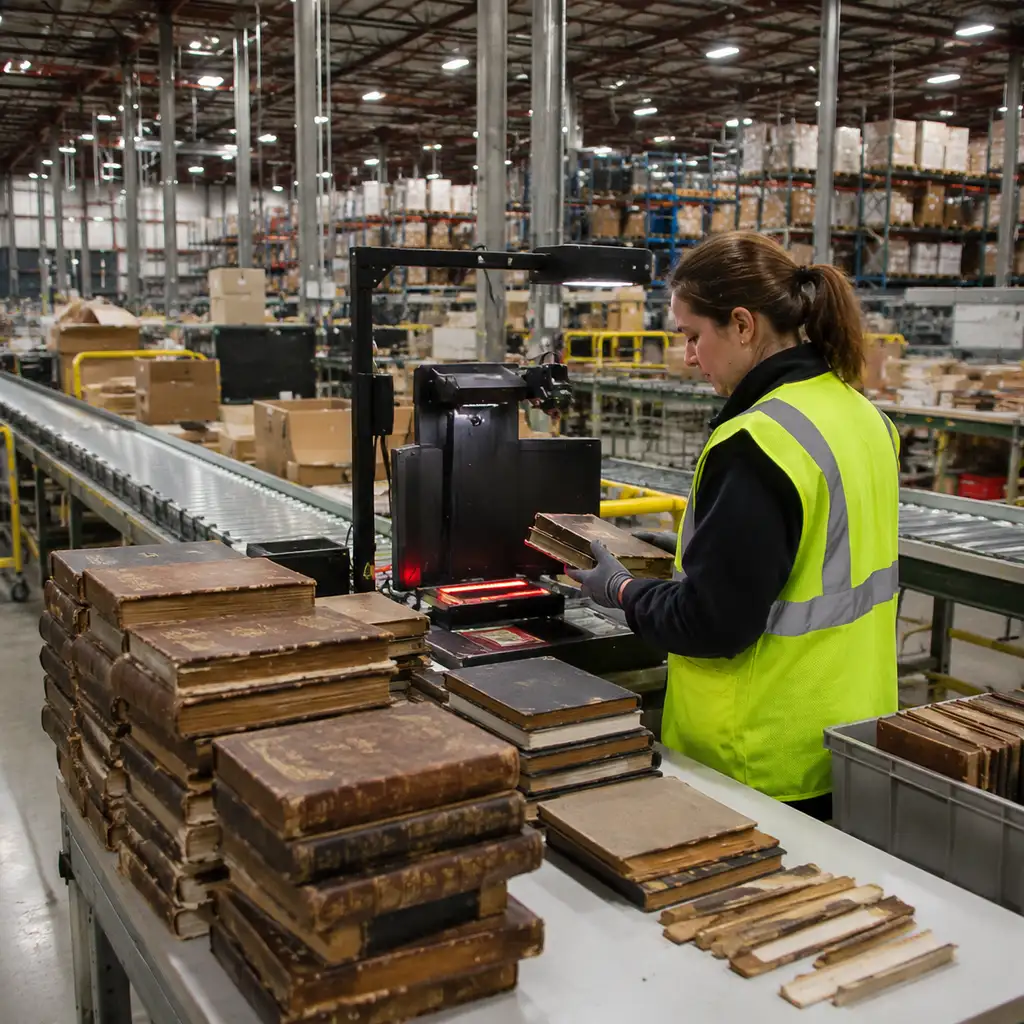
亚马逊拆书扫描训练AI,靠的是一份官司抄来的剧本
404 Media用追踪器锁定亚马逊拉斯维加斯仓库VGT3,证实其正购入稀有书籍拆书脊、扫描后训练AI模型。这套“购买—扫描—销毁—留一份数字副本”的操作,几乎照搬了Bartz v. Anthropic案里被法院认可的合理使用范式,但训练环节本身是否合法,判决并未给出答案。
自称「语音版OpenRouter」,Speko真正要闯的关是测评可信度
Speko上线语音AI统一网关,用OpenAI兼容接口接入多家STT、LLM、TTS,宣称按语言和任务自动选模。目前公开的量化对比只覆盖STT一项,测评方法、实时延迟、故障切换机制均未公开。能不能把选型权交给它,现在还看不清。
Nvidia宣称的260亿美元开源投资,其实是一张滚动账单
Nvidia重注的开源模型Nemotron,被外界包装成一场260亿美元的豪赌,但SEC文件显示这其实是一份逐年滚动、已两次上调至300亿美元的云算力采购合同,且口径含糊到不专门指向开源模型。真正决定这场赌局输赢的,不是账面数字,而是基础模型训练本身正在变得像几年前的预训练一样不可及。
DiG-bench与Faraday测试AI发现能力:会复现,离会发明还有多远
Import AI第469期介绍了DiG-bench和Faraday:前者测试AI能否摸索隐藏规则,后者测试科研代理能否组织论文复现。两项结果说明前沿系统已开始接触“发现”的部分环节,但高难任务成功率、工具依赖和模型裁判都限制了结论强度。实验室该按可复现产出追加预算,政策研究者则要追问能力扩散背后的算力与分发权。
3M专家证人被曝靠ChatGPT写报告,官方调查却从未点名3M
休斯顿Watson Grinding爆炸案诉讼中,3M专家证人Josh Autenrieth被曝先设定“3M零责任”结论再让ChatGPT找证据,350页提示词记录被原告方强制取证并公开。更值得追问的是,官方CSB调查报告全文从未点名3M,AI造假争议只是这起责任认定官司的一个枝节。
55%到68%:人眼分辨AI造假的准确率,正逼近抛硬币
404 Media一期播客预告把'和deepfake专家聊未来'包装成大新闻,实质内容全藏在付费墙后,但受访者Hany Farid近一两年在多个公开场合给出的数据更值得关注:人类辨别AI生成图像、语音、视频的准确率已跌到55%到68%区间,仅比随机猜测高一点,而检测器在不同生成器上的表现可以从四成多飙到近满分,说明'技术终将追上造假'这套乐观叙事本身就站不住。
一枚AirTag,追出亚马逊的秘密书籍销毁仓库
记者在一批约1000本书里藏了一枚AirTag,跟着货运轨迹跨越四个州,最终锁定亚马逊拉斯维加斯仓库里一个叫VGT3的隐秘作业区——员工称那里整天切书脊、扫描、销毁原书。亚马逊的回应只承认购书用于产品开发,训练用途、销毁规模和招聘话术里的模糊处理都没有回应。
OpenAI俄亥俄8GW大单:政府没出钱,账本也没打开
OpenAI联合SB Energy、NVIDIA和美国能源部在俄亥俄州派克县锁定约8吉瓦算力容量,承诺自付电网成本、追加社区投入超1.6亿美元。但“约8GW”与外界流传的“至多8GW”之间有弹性空间,能源部只是场址监管方而非出资方,项目总投资规模也从未公开。
推箱子游戏14题秒解,第15题却要提前算好答案
一个开发者做的推箱子(Sokoban)在线求解器,1-14号棋盘浏览器毫秒级给出证明最优解,唯独15号棋盘要靠原生C++版本用24线程算5.3秒、扩展4909万个状态才求出184步答案,页面只是回放。这背后是Sokoban求解界两条老路线——push-optimal和move-optimal——代价差出一整个量级的老问题。
检测涨三倍,GPT-5.6 Sol的部署账却没那么好算
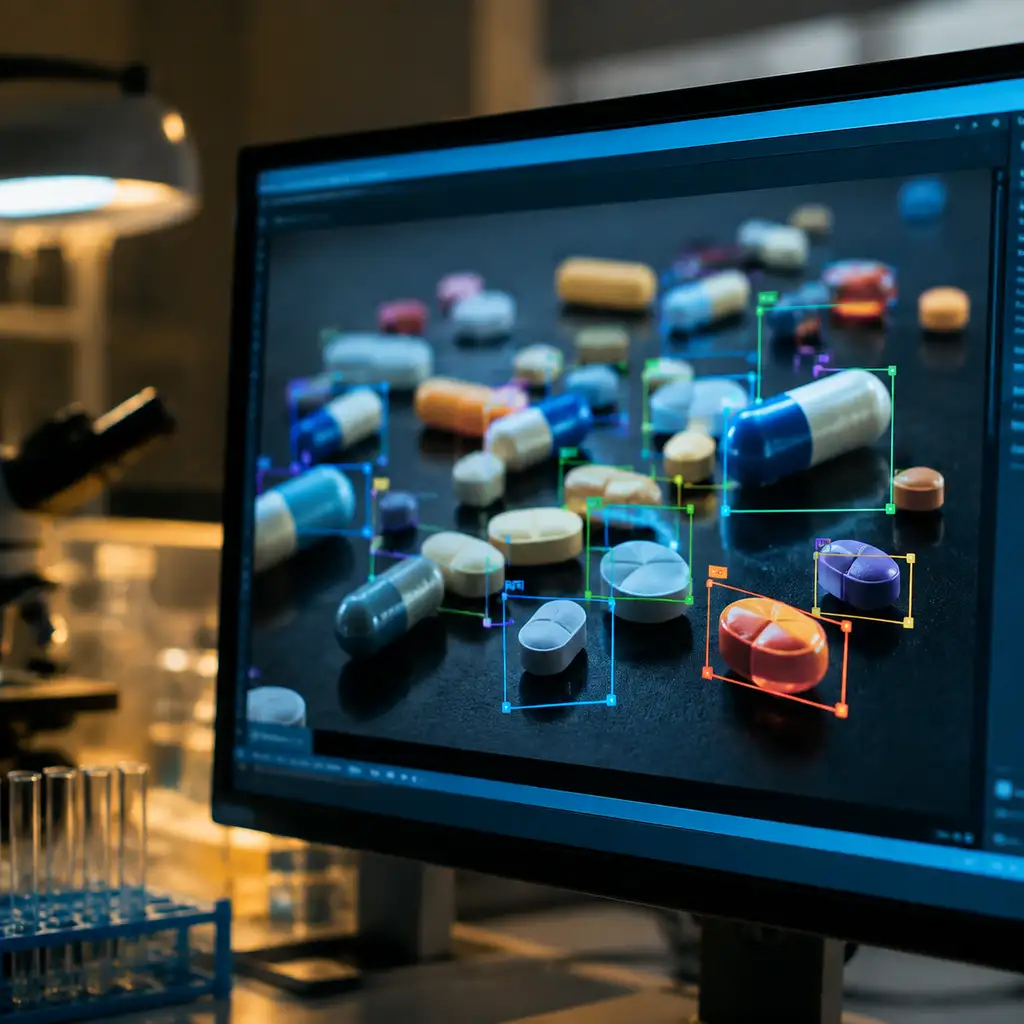
Roboflow自测显示,GPT-5.6 Sol的检测mAP@50从GPT-5.5的13.8跳到46.2,计数准确率升到73.0%,是OpenAI自家历代最强的视觉模型。但OCR和文本提取没有同步进步,单张图要跑近10秒、花2.5美分,高分辨率下还容易框选失稳,综合性价比仍不及Gemini 3.5 Flash。
OpenAI资助14个智库研究AI政策,谁被选中比给多少钱更关键
OpenAI宣布向14个机构提供总计100万美元现金加最多100万美元API额度,资助其研究AI时代的经济机会与社会韧性议题。名单看似跨越政治光谱,实则集中在建制化政策机构,劳工组织、消费者团体和全球南方声音基本缺席,资助条款是否公开也无从查证。
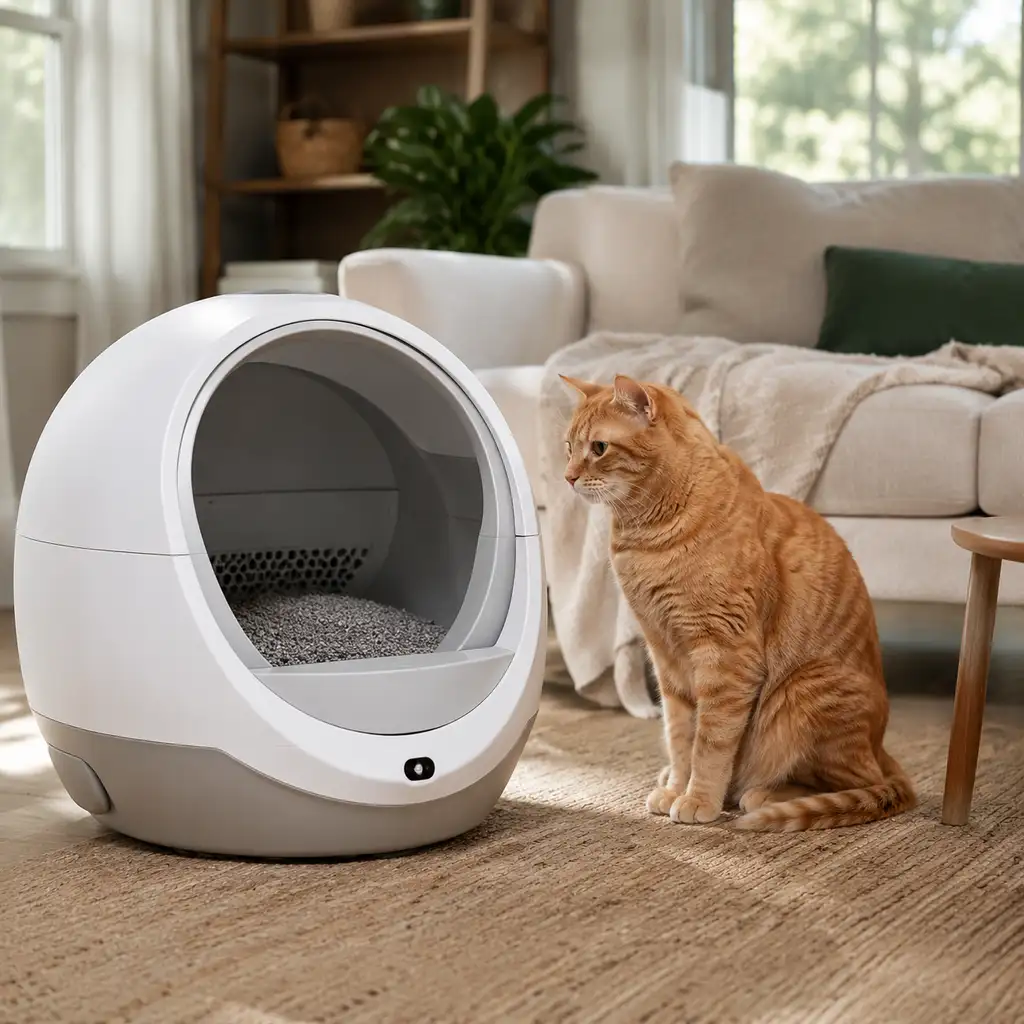
899美元的AI猫砂盆,连自家两只猫都认不清
Whisker的899美元旗舰猫砂盆Litter-Robot 5 Pro主打AI摄像头认脸,却把两只猫的身份搞混。往下拆会发现,这不是偶发失误,而是识别对了也会被系统覆盖的架构问题,核心功能还锁在订阅墙后,摄像头和麦克风又默认开着。