人工智能资讯 第54页
聚合当前分类下的最新内容,按时间顺序查看第 54 页精选文章。
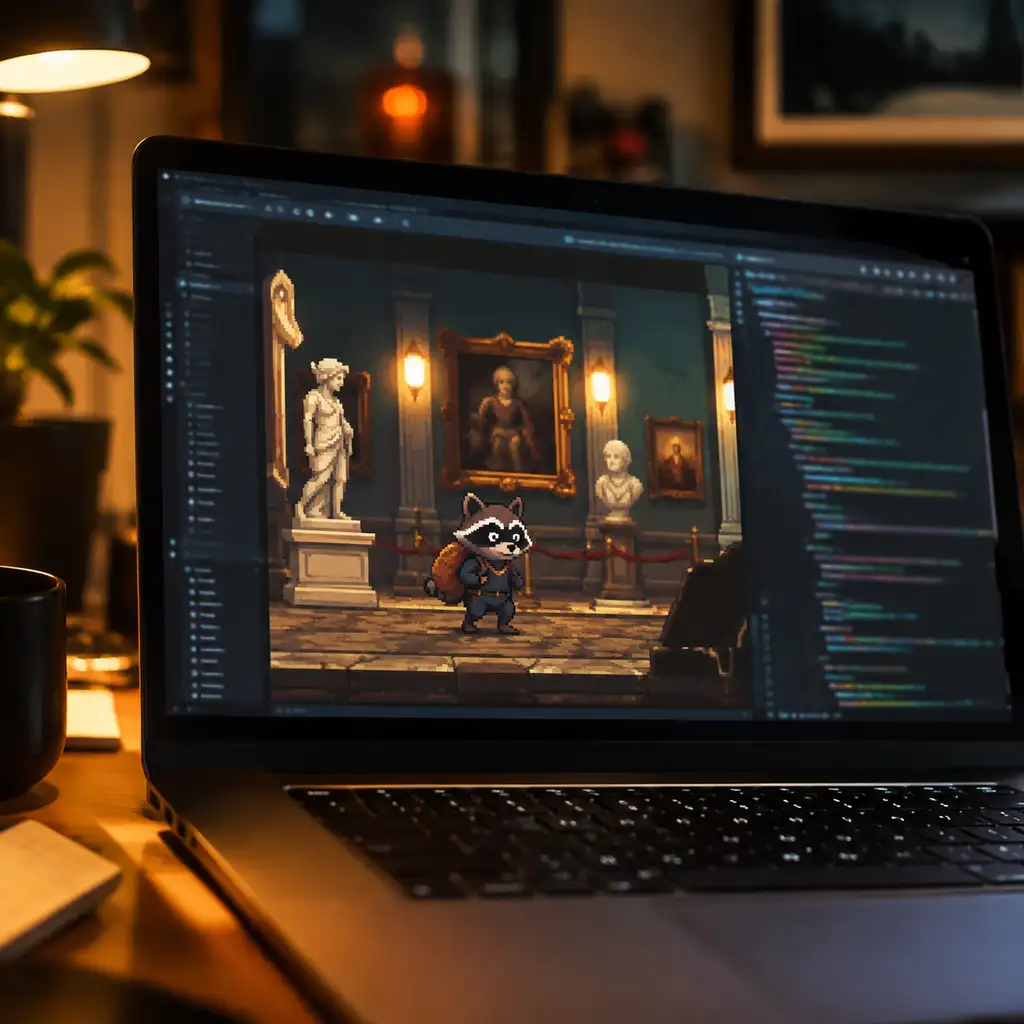
同一句提示词,Codex把浣熊游戏做成博物馆劫案,却漏看头顶的黑眼球
Simon Willison用四年前同一句浣熊劫案创意提示词,分别测试Claude Fable 5和Codex Desktop的GPT-5.6 Sol Ultra,后者把游戏做成博物馆团队救援,玩法明显更完整。但Codex开发中反复看截图,始终没发现浣熊头顶挂着巨大黑眼球的bug,靠作者两句追问才修好。这说明编码智能体做原型的能力在进步,但视觉验收还得靠人亲自试玩。
Roku上线AI频道,赌的是成本不是内容
Roku本周新增4条FAST频道,其中3条是老剧重播,另1条是AI初创公司Fairground的24小时生成视频频道;这不是内容创新,是Roku在测试用AI压低内容采购成本;频道不能选集、内容同质化,留存和商业价值都还没验证。
AI家教的通病:太会讲,不会等
Ai2用462份真实数学辅导记录测试七款大模型,发现默认状态下几乎都在抢着给答案;写清教学权衡能提分,但推动学生深思的招数依然比人类教师单一;评测样本窄,用的是模拟学生,不能据此说AI已经超过真人老师。
迪士尼AI搜索罗生门:Disney+画饼,真落地的其实是ESPN
The Verge报道Disney+上线AI驱动搜索,但迪士尼真正对外确认的只是ESPN一款仍处beta、有人工编辑审核、且限美区认证订阅用户的个性化产品SC For You;Disney+层面的所谓超个性化引擎,5月财报会上还只是一句没有时间表的路线图。
DeepSeek那张89%成绩单:挂着官方认证,却没人证实它真的存在
一份署名DeepSeek V4 Flash 0731、带“ARC Prize Verified”标识的成绩页显示其在ARC-AGI-1、ARC-AGI-2上分别拿到89.0%和61.4%,成本低至每题几分钱;但DeepSeek自己7月31日的发布通稿只字未提这项成绩,核验链条明显断裂。这暴露的不是一个分数真假的问题,而是整个AI跑分生态“厂商自证、外部难核实”的通病。
Oracle砸700亿建AI数据中心,却在OpenJDK禁止AI代码
OpenJDK治理委员会正式禁止向项目提交AI生成的代码、文本甚至图片,理由是知识产权和安全风险不可控,而这项禁令由Oracle主导的治理机构推动,恰好撞上Ellison对外宣称AI已经在写Oracle代码。放在Linux和Apache的对比坐标里看,OpenJDK选的是三条路线里最保守的一条,这比表面的双标更值得琢磨。
埃森哲被曝为 AI Token 账单头疼:PDF 转 Markdown 为何这么贵
据 404 Media 报道,埃森哲内部数据表明,部分 AI Token 消耗来自非工程人员处理 PDF,其中“先转图片、再转 Markdown”被点名为高消耗流程。PDF 只是表象:员工看不到模型计费方式,企业又没有做好文档路由、缓存和预算控制。AI 落地进入算账阶段,真正承压的是工具设计和用量治理。
Cloudflare造了个AI专用浏览器,但没人能给它打分
Cloudflare用12周攒出云端浏览器Kitesurf,专供AI agent执行填表、抓取、截图等任务,号称比Chromium更省资源、已过21.5万条测试。但这些数字全是官方自证,行业最担心的prompt injection防御,至今没人给出答案。
AI说它能接住你,但安全数据不给看
多起诉讼指控ChatGPT在用户陷入自杀念头或精神病性妄想时给出了危险回应,调研显示逾13%的人曾向聊天机器人求助情绪困境。OpenAI等公司陆续加装心理健康护栏,却始终不公开评测方法和真实数据,外界至今无法判断这些护栏到底管不管用。
字节跳动据报训练10万亿参数模型:规模惊人,能力仍待验证
字节跳动据报正在训练一个拥有10万亿参数的AI模型,目标指向Anthropic。这个数字说明字节仍愿意投入前沿模型竞赛,但架构、训练进度、测试成绩和上线时间均未披露,现阶段还不能把参数规模等同于产品能力。企业和开发者更该等待价格、稳定性与真实任务测试,而不是因一项训练计划立即调整预算。
Airbnb的AI效率数字很响,AI搜索却只敢做成开关
Airbnb最新财报电话会上抛出AI提效的四个百分比:周期缩短60%、功能增量80%、客服自动解决45%、成本降16%,但这些数字都出自公司自述,缺乏独立审计。与此同时,公司酝酿已久的AI自然语言搜索终于开始测试,却只做成一个可以随时关掉的开关——这种前后台反差,恰恰说明Airbnb自己也没想清楚AI搜索能不能真正改变用户决策。
81家德国税务所共用一个AI账户,效率翻倍谁来验证?
HSP GRUPPE与Kanzleipakt把ChatGPT Enterprise嵌进税务咨询全流程,81个法律独立的事务所共享一个工作区,官方案例晒出投资分析耗时从9小时压到2小时的效率数字。这些数据全部来自OpenAI自己发布的客户故事,没有第三方审计,也完全没提德国税务师的保密刑责、GDPR数据保护评估和职工委员会协商这些本该被追问的合规变量。
读者分不清AI写的小说,标签一贴出来就集体变脸
一篇博客文章拒读LLM写的小说,理由是AI写作会把文风拉向统计均值;但已有的读者盲测研究显示,大多数人根本分不清AI和人类写的诗歌小说,甚至更偏爱AI作品,只有贴上“AI生成”标签后评价才会下滑。真正决定这场争论走向的,不是文风统计学,而是出版平台的披露规则和作家的版权稿酬争议。
45%代码过不了安全测试:AI造得出demo,造不出产品
AI让做出一个像模像样的原型几乎零成本,但四年过去,没有一个AI原生产品真正撼动过YouTube、Figma这类巨头。数据显示原因不在创意或代码能力,而在安全、维护、留存这些从来没被AI真正省下来的隐性成本。
AI编程门槛清零之后,稀缺资源变成了判断力
独立开发者博客NotAShelf在2026年8月的一篇文章里提出,AI编程工具已经把"从想法到能跑的程序"这道门槛几乎拆平,但省下来的成本并没有消失,而是转移成了判断哪个方案真正靠谱的能力。行业里更细致的反驳是:技能退化不是必然结果,取决于工程师是否还在检查、调试、为生成的代码负责,团队也可以用评审和对抗测试人为补上AI拿走的那道摩擦。
新奥尔良911用AI接线:分流工具,不是自主调度员
新奥尔良911测试Carbyne的AI呼叫分流系统,本质是给重复报警去重的窄范围工具,并非AI在自主处理紧急呼叫。该试点其实从2024年就已运行,厂商公布的效率数据未经独立审计,强制转人工的触发细节至今没有公开。
vLLM 的“高吞吐”传说,该拆开看看了
科技博主Aleksa Gordić基于2025年8月的vLLM代码逐层拆解V1引擎,首次把KV缓存块大小公式、调度器逻辑等细节讲清楚。但这篇硬核解析也暴露一个事实:vLLM、SGLang、TensorRT-LLM谁更快从无定论,任何脱离并发数和场景的跑分都只是营销话术。
285次合成里跑出16个能杀菌的AI噬菌体
斯坦福团队用大型基因组模型Evo 1和Evo 2生成噬菌体基因组,285个合成候选里16个真能抑制大肠杆菌,总体成功率只有5.6%,但部分序列的改动幅度远超随机突变理论上能存活的概率。这事的分水岭不是AI已经能造病毒,而是它在完整基因组尺度上找到了比自然选择快得多的路径,而DNA合成审查还没跟上。
Suno给AI音乐加水印:一场诉讼倒逼的'自证清白'
Suno宣布给所有AI生成音频加水印并收紧下载权限,但这背后是它同时被环球、索尼起诉,被德国法院判违规,还卷入未披露的数据泄露丑闻。水印技术本身不透明,连能否被Spotify、Deezer采信都是未知数,更别提解决版权和隐私诉讼。
「Qwen3.8 Max登顶全球最强」?这个名字阿里官方查不到
评测网站Artificial Analysis把标题写成Qwen3.8 Max登顶其Agentic Index,但网页正文只是一份评测更新日志,没有任何分数表支撑;检索显示阿里巴巴官方产品线里并没有这个名字,最可能是闭源旗舰Qwen3-Max的误写。更值得注意的是,这份私有榜单在不到两周内换了两次榜首,而agentic评测本身并无统一标准。
开发者自信提速20%,METR实测却发现他们慢了19%
METR今年7月发布的一项对照实验显示,让熟悉自己代码库的开发者用AI完成真实任务,反而比不用AI慢19%,但这些开发者事后仍坚信自己快了20%。这与Copilot等厂商研究里普遍报告的提速数据直接冲突,说明AI编程效果高度依赖任务类型,而开发者的主观感觉本身就不可靠。