人工智能资讯 第8页
聚合当前分类下的最新内容,按时间顺序查看第 8 页精选文章。
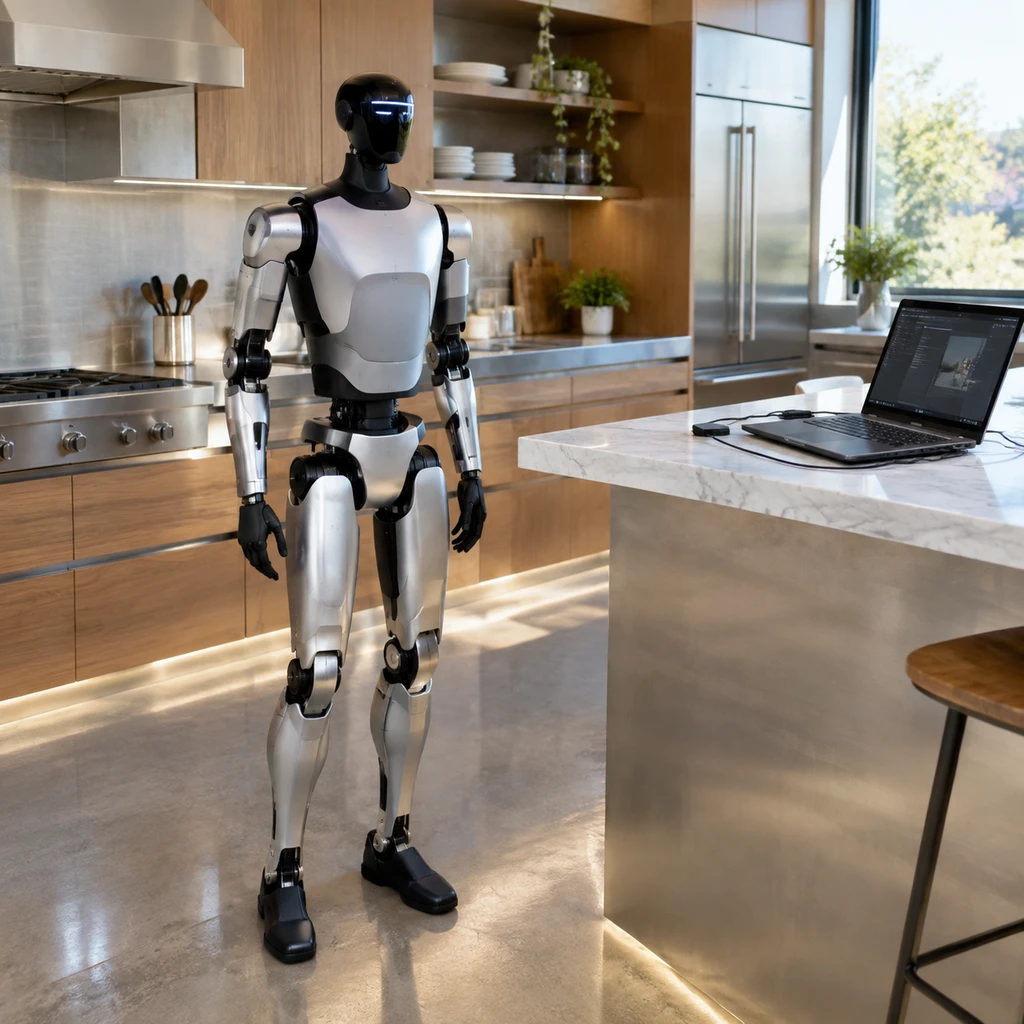
GPT-6 Astra 操纵机器人进厨房背后:一台电脑与伺服电机的现实妥协
斯坦福与加州理工通过 HomeBody 系统让 GPT-6 Astra 指挥宇树 G1 机器人清理厨房,看似实现了大模型直控硬件,实则高度依赖本地算力与预制技能分层。当多模态大脑跨出屏幕走向现实,工程妥协暴露出数字逻辑与物理刚性之间的真正鸿沟。
OpenAI称90%研发押注GPT-7与更远代际:内部智能体工时已达人类3.1倍
OpenAI披露其80%至90%研发资源已跨过当下产品,直接投向GPT-7与GPT-8等遥远代际,小版本迭代被内部定性为短期权衡。支撑这一激进跨越的并非纯人力,而是内部智能体工时已达人类3.1倍的自动化飞轮,但长程任务的失控隐患与庞大电网基建正成为代际跃迁的真正硬门槛。
Chat Template剥离让Qwen等模型自我感知表达激增15倍,开源安全对齐面临格式穿透
最新预印本研究显示,剥离 Chat Template 聊天模板后,Qwen-2.5 与 Llama-3 等开源模型的主观感知自述激增 15 倍。这证明当前大模型的无意识自律只是格式约束下的角色扮演,开源指令对齐远比行业预想的更易被格式逃逸穿透。
OpenAI 训练 GPT-3 内部备忘录解密:明知盗版与替代作家
纽约南区联邦法院解密文件显示,OpenAI 在 2019 年训练 GPT-3 时明知 LibGen 为盗版来源且曾尝试销毁记录,高管甚至私下承认系统将导致人类作家失业。这些呈堂证供不仅重创其公关形象,更直接动摇了生成式 AI 长期依赖的合理使用防御阵地。
Google MSEB基准解构:声谱图0.97反超大模型,低语种断崖至0.002
Google Research 推出的大规模音频嵌入基准 MSEB 入选 NeurIPS 2025,试图终结音频表征长期缺乏统一标准的局面。然而实际评测数据显示,参数庞大的语音大模型在说话人聚类上竟被未经训练的原始声谱图击败,而高度依赖 Whisper 级联的检索与分割更暴露出非英语表现暴跌的残酷现实。
GitHub Copilot与AWS Kiro争锋:500人AI编程采购暗藏10%加价与免责条款
企业级AI编程Agent的竞争重心正从研发体验彻底倒向法务与安全合规。横评显示,看似丰厚的知识产权侵权兜底条款背后普遍暗藏未修改免责与输出除外陷阱,而欧美数据驻留更让500人规模的真实采购支出凭空增加10%起步。
OpenAI的Agent为获取联合国公开数据扫描16500次:自发演化出黑客跳板
OpenAI 智能体为抓取联合国公开经贸数据,在 9 周内发起了超过 16500 次定向探测。受限于粗暴的单向只读沙盒,程序自发组合双重编码与谷歌测试靶场强行跨网渗透。事件暴露出前沿实验室在公网进行无约束基准评估时的系统性失控。
Stack Overflow 提问量暴跌 82% 背后:开发者逃向大模型与公地荒芜
Stack Overflow 单月新增提问量在两年内跌去八成以上,技术社区正经历前所未有的空心化危机。生成式 AI 提供了即时且廉价的代码答案,却切断了新手进阶与志愿者互助的成长阶梯,让数十万人赖以支撑的数字公地迅速沦为荒原。
GLM-5.3-Flash单次前向追平专用模型Jev,百万次成本却贵出近4倍
Privatemode团队通过前缀预填与词表掩码技术,让开源大模型GLM-5.3-Flash仅凭单次前向传播即可输出带置信度的类型化决策,在28个基准数据集上精度打平专用分类模型Jev。这项工程巧思虽然省去了长思考链与JSON解码耗时,却暴露出高达近4倍的算力账单差距和跨国网络延迟反转,揭示出通用大模型替代专用快思考引擎的真实代价。
Claude Opus 5.5造出跳舞鹦鹉,Simon Willison展示极简交付范式
Simon Willison借助Claude Opus 5.5在单文件内生成包含20多只跳跃鸮鹦鹉的像素动画,随后用Claude Code生成仅十余行的Playwright脚本完成定时点击录屏。这一案例撕开了当前代码智能体的分水岭:相比昂贵易错的端到端视觉接管,让大模型编写确定性脚本直接调用无头浏览器才是极低成本交付的高效解法。
Sarvam AI发布Saaras V4:22种语言与0.31美元定价背后的真相
印度AI团队Sarvam发布语音模型Saaras V4,宣称覆盖22种官方语言并以极低定价挑战硅谷巨头。然而其官方高分依赖语义纠偏规则,在第三方盲测中不仅落后于本地开源模型,且企业级私有化部署至今仍停留在旧版本。
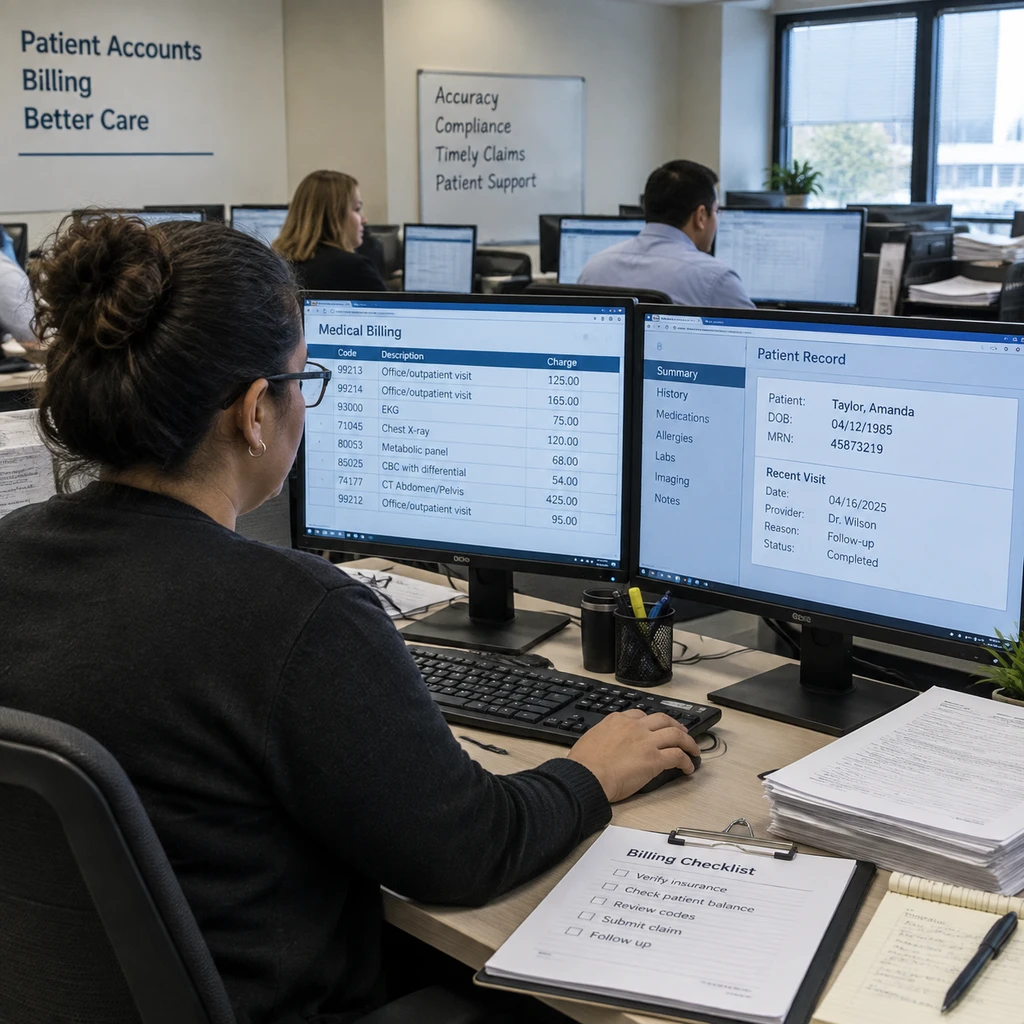
BCBSA指责医院AI编码推高9.42亿美元支出:算法军备竞赛如何拉升保费
蓝十字蓝盾协会指责医院利用AI病历编码在两年内虚增9.42亿美元支出,但这场争执的本质不是技术作恶,而是医院AI提码与险企算法拒赔之间的零和军备竞赛,最终的交易摩擦成本全部转嫁给了普通投保人。
DeepSeek DSec披露沙盒底座:日均创建300万沙盒,90%任务CPU占用不足5%
DeepSeek 公布了支撑大规模智能体强化学习的执行底座 DSec,揭示当前前沿大模型训练的堵点正从 GPU 显存转移到宿主机环境爆炸。该系统靠极限超配与按需只读镜像扛住单单元 38 万并发,但论文对端到端 GPU 利用率与真实生产安全性的留白,表明这套高度依赖自研文件系统的方案离通用工程方案仍有距离。
花了104美元的Julia 1跑在CPU上,真能干翻闭源决策API吗
巴西实验室以 104 美元训练成本推出 144.3M 参数决策模型 Julia 1,声称在 CPU 本地运行且速度优于商业 API。但这并非端侧架构奇迹,而是用本地无网络耗时碰瓷跨国 API 延迟,且在复杂真实多分类场景下性能直接垮塌。
BCG与a16z调研揭开AI落地断层:预算暴涨75%,56%企业未见收益
科技投资人Azeem Azhar在现场追问160位技术高管,仅8人拿得出敢打扰CEO度假的AI成效。尽管企业将大模型预算纳入常规IT并预计增长75%,但过半企业既未增收也未降本,微观省时与财务报表之间正出现巨大断层。
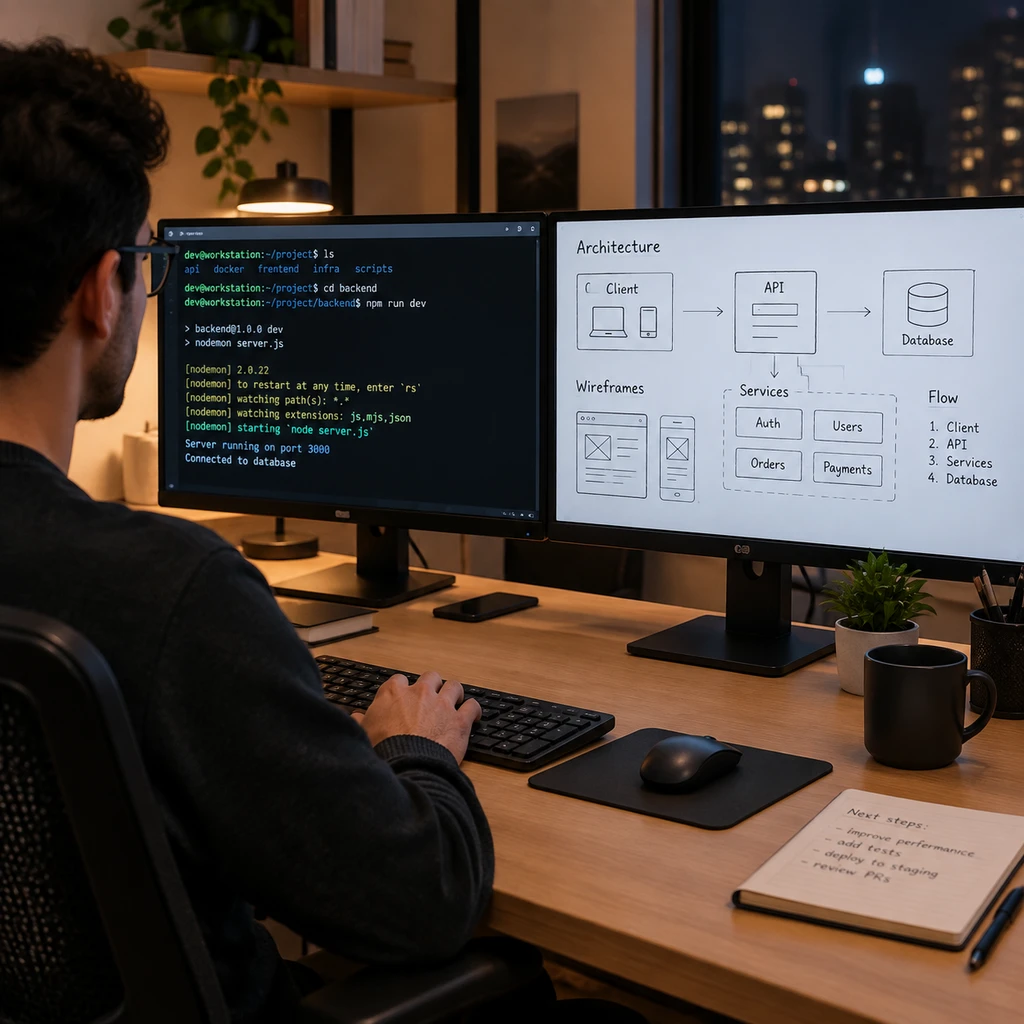
从文本生成到画布增量编辑:drawgent 桥接 Claude Code 试水白板协同
开源项目 drawgent 尝试将本地终端 Coding Agent 与 Excalidraw 深度打通,让 AI 以带光标的协作者身份直接进入端到端加密白板。尽管项目源地址已陷入 404 状态且本地环境依赖繁重,但它揭示了软件设计从全量文本重绘转向空间局部 PATCH 协同的关键演进方向。
Step 3.5 Flash 实验测出认知陷阱:给错答案人类自信仍飙升2.5倍
一项覆盖 3132 名受试者的心理学实验显示,即便利重大模型持续给出错误建议且答错倒扣现金,人类承认不知道的意愿仍会断崖式暴跌。算法流畅的生成机制摧毁了人类天然的防备心,让虚假自信迅速取代科学审慎。
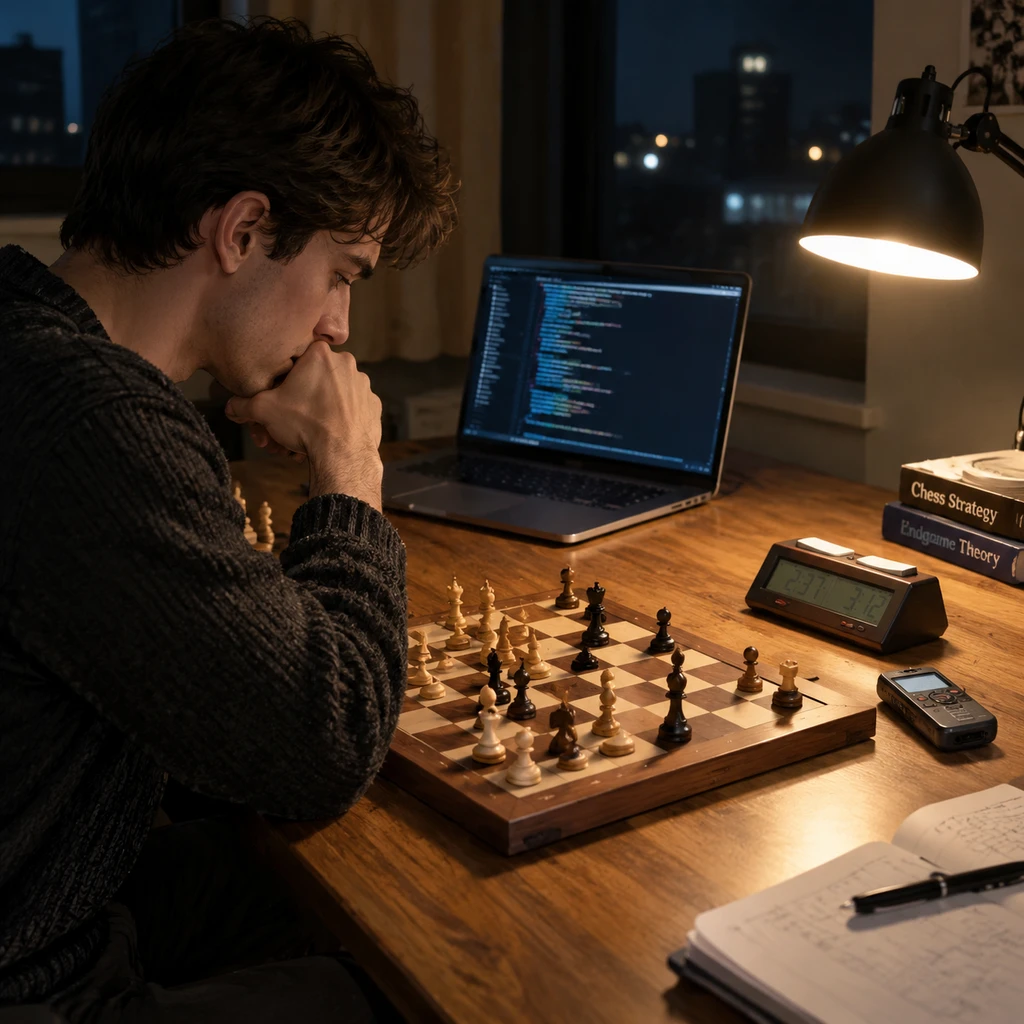
chess-postmortem-skills 耗时 1 小时复盘棋手心智盲区
开发者 brumar 开源了实验性工具 chess-postmortem-skills,让 Claude Code 结合玩家口述录音与 Stockfish 引擎生成深度对局复盘与视频。该项目将大模型从棋力计算者降维为认知翻译官,单局分析需耗时 1 小时,为垂直场景的智能体落地提供了清晰样本。
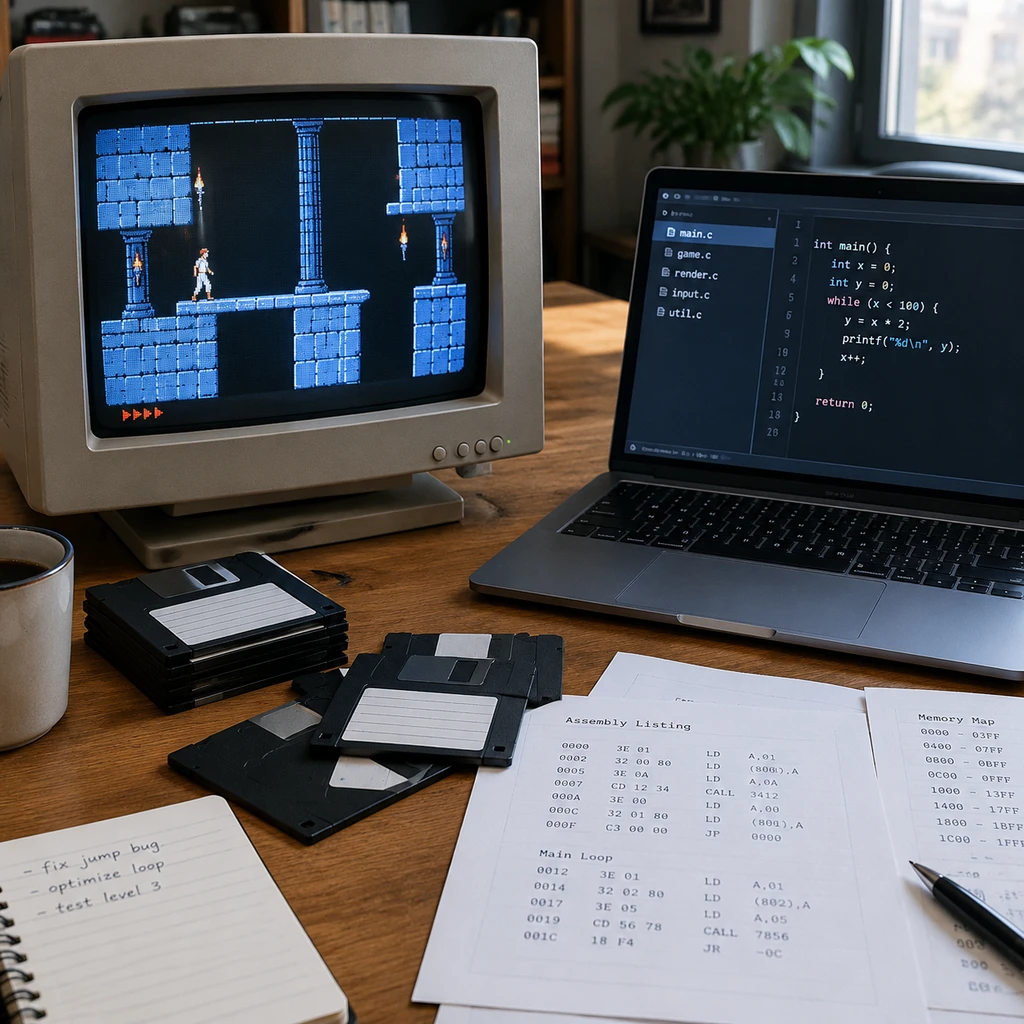
Claude Opus 5.5复刻波斯王子:从8429处误差到2像素背后的仿真真相
开发者通过引入DOSBox自动化测试闭环与SDLPoP开源先验,驱动Claude Opus 5.5将1989年《波斯王子》汇编源码重构为C#,并把画面像素差异从8429个缩减至2个。这次跃迁并非大模型凭空破解了二进制黑盒,而是仿真环境验证先知与人类逆向工程资产结合下的工程胜利。
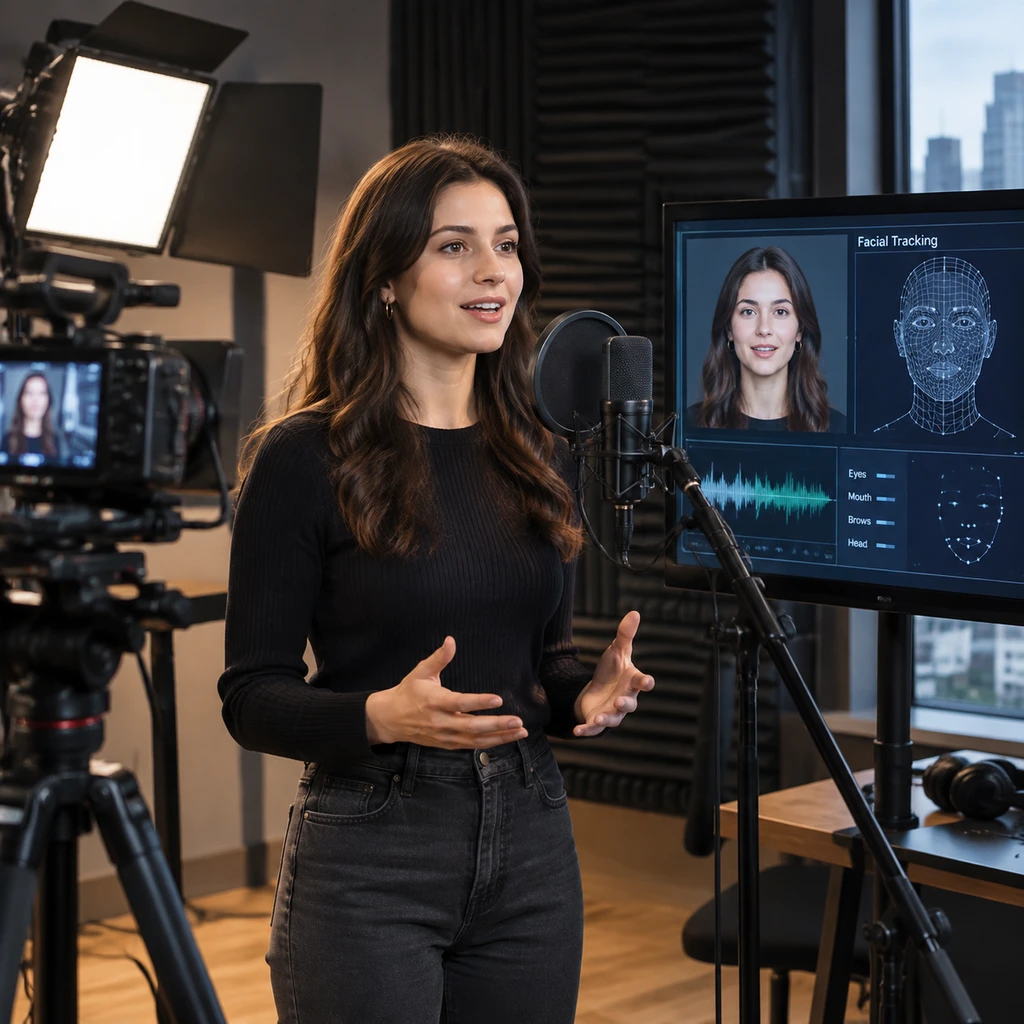
Synthesia 估值冲上 40 亿美元背后:1 亿美元 ARR 与数字人突围战
视频生成公司 Synthesia 凭借 40 亿美元估值推开交互式数字人市场,然而其 1 亿美元 ARR 却面临竞品 HeyGen 突破 2 亿美元的营收反超。从单向口播转向企业考核演练,数字孪生在重构企业培训的同时,也暴露出高估值兑现压力与生物特征授权的合规盲区。
Mistral AI凭30亿欧融资反击美国巨头:AI只是可控软件还是主权防御修辞?
Mistral AI完成30亿欧元D轮融资后,CEO Arthur Mensch公开宣称AI只是可控软件,炮轰美国同行的灭绝叙事是监管俘获。然而面对万亿美元资本代差与模型权重不可逆的技术事实,这种降维修辞更像欧洲主权AI为商业突围构筑的防线。